dplyr로 분석용 데이터 만들기: 필터링부터 집단별 요약까지
평균을 그리려고 했는데 막대가 예상과 다르게 나왔다면 어디부터 볼까요? 그림 함수보다 입력 표의 행 단위와 요약 기준을 먼저 살펴보면 원인을 찾기 쉬울 수 있습니다.
전처리(data preparation)는 함수 여러 개를 연결하는 작업이기도 하지만, 질문에 맞는 표를 만드는 과정인데요. 원자료에서 집단별 요약표까지 한 단계씩 따라가 보겠습니다.
그림을 그리기 전에 어떤 표가 필요할까요?
막대그래프 글에서는 제조사·구동 방식별 평균을 먼저 계산했습니다. 이처럼 분석 질문에 맞는 표를 만드는 데 dplyr를 사용할 수 있습니다. 이번 질문은 “구동 방식별 고속도로 연비는 어떻고, 그 비교에 사용된 표본은 몇 개인가?”입니다.
# 설치는 처음 한 번만 합니다.
install.packages(c("dplyr", "ggplot2"))
library(dplyr)
library(ggplot2)

cars <- ggplot2::mpg
dim(cars)
names(cars)
head(cars)
234개 행과 11개 열이 있습니다. 행 하나는 제조사 하나가 아니라 자동차 사양에 관한 관측값입니다. 같은 제조사의 여러 행을 독립적인 제조사 표본처럼 해석하면 안 됩니다. 데이터 설명은 ?ggplot2::mpg에서 확인해 보세요.
어떤 함수가 행과 열을 바꿀까요?
| 함수 | 하는 일 | 확인할 점 |
|---|---|---|
filter() |
조건에 맞는 행 선택 | 빠진 행과 NA 조건 |
select() |
사용할 열 선택 | 식별자·단위 열 보존 |
mutate() |
새 변수 생성 | 단위·자료형·분모 |
group_by() |
집계할 집단 지정 | 요약 후의 행 단위 |
summarise() |
집단별 요약 통계 계산 | 유효 표본 수·결측 수 |
%>%는 왼쪽 결과를 오른쪽 함수의 첫 번째 인자로 넘깁니다. 중간 결과를 변수에 담아 나누어 실행해도 됩니다. 표가 기대와 달라지면 한 단계씩 확인하는 편이 원인을 찾기 쉽습니다.
행·열·단위는 어떻게 정리할까요?
selected <- cars %>%
  filter(year == 2008, !is.na(hwy)) %>%
  select(manufacturer, model, drv, hwy, cty) %>%
  mutate(
    hwy_km_l = hwy * 0.425144,
    highway_city_gap = hwy - cty
  )

nrow(selected)
head(selected)
2008년 관측값은 117개입니다. 미국식 mpg를 km/L로 바꾸기 위해 약 0.425144를 곱했습니다. 연비와 연료 소비량은 역수 관계이므로 L/100km와 혼동하지 마세요.
filter(hwy > 25)는 조건이 참인 행만 남깁니다. hwy가 NA이면 비교 결과도 NA가 되어 제외됩니다. 누락을 보존해야 한다면 filter(is.na(hwy) | hwy > 25)처럼 의도를 명시해야 합니다.
집단별 평균에는 왜 표본 수도 필요할까요?
집단 평균들을 다시 평균내면 전체 평균이 될까요? 집단 크기가 다르면 관측값이 많은 집단에 더 큰 비중을 주어야 합니다. 같은 유효 관측값을 겹치지 않게 나누었다면 다음 관계가 성립합니다.
\[\bar x=\frac{\sum_j n_j\bar x_j}{\sum_j n_j}.\]n_j는 집단 j의 유효 표본 수입니다. 그래서 평균과 함께 n을 보관하는 습관이 후속 집계에서도 도움이 됩니다.
아래는 전체 연도 자료를 다시 사용합니다. selected를 쓰면 2008년으로 질문이 달라지므로 입력 객체를 확인해 보세요.
by_drive <- cars %>%
  group_by(drv) %>%
  summarise(
    n_total = n(),
    n_observed = sum(!is.na(hwy)),
    n_missing = sum(is.na(hwy)),
    mean_hwy = mean(hwy, na.rm = TRUE),
    median_hwy = median(hwy, na.rm = TRUE),
    sd_hwy = sd(hwy, na.rm = TRUE)
  ) %>%
  ungroup() %>%
  arrange(desc(mean_hwy))

by_drive
stopifnot(sum(by_drive$n_total) == nrow(cars))
n()은 집단의 전체 행 수를 셉니다. mean(..., na.rm = TRUE)에서 실제 평균 계산에 쓰인 수와 다를 수 있으므로 유효 표본 수를 따로 넣었습니다. 모든 값이 결측인 집단에서는 평균이 NaN이 될 수 있습니다. 이를 0으로 바꾸면 “관측값이 없음”이 “평균이 0”으로 바뀌므로 구분해서 표시하세요.
ungroup()은 남아 있을 수 있는 그룹 설정을 해제합니다. 특히 여러 변수로 묶은 뒤 요약할 때는 이후 계산이 전체 기준인지 집단 기준인지 명확하게 하는 습관이 좋습니다.
요약 결과를 그림으로 확인해 볼까요?
ggplot(by_drive, aes(x = reorder(drv, mean_hwy), y = mean_hwy)) +
  geom_col(fill = "#538f76", width = 0.6) +
  geom_text(aes(label = paste0("n = ", n_observed)), vjust = -0.5) +
  expand_limits(y = 32) +
  labs(x = "Drive type", y = "Mean highway fuel economy (mpg)") +
  theme_light()
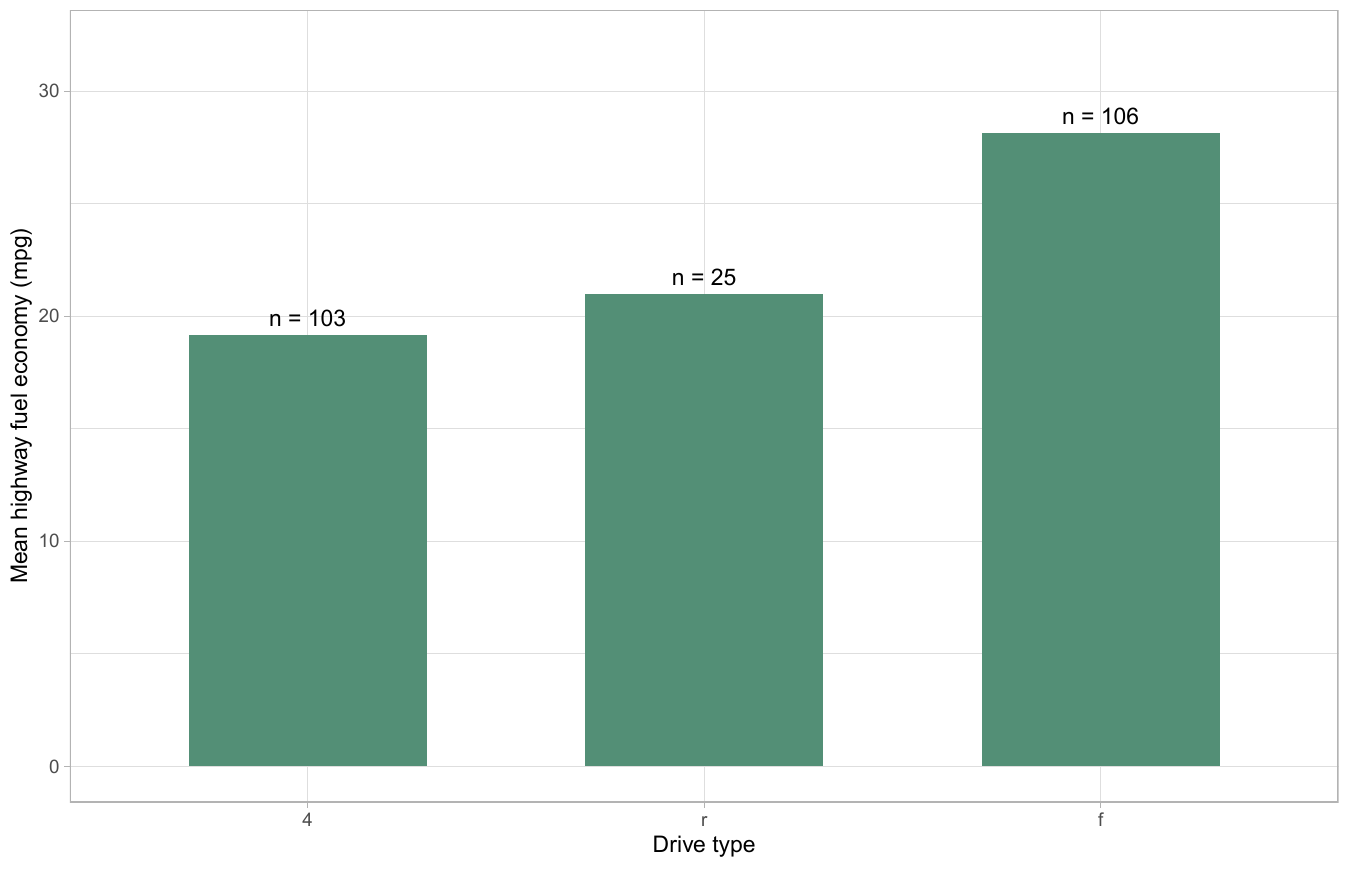
여기서 평균이 가장 큰 집단을 “구동 방식 때문에 연비가 좋아졌다”고 해석할 수는 없습니다. 차종, 배기량, 연식 등이 함께 다릅니다. 집단별 분포를 함께 보아야 평균에 가려진 차이도 확인할 수 있습니다.
표를 합치면 행이 늘어날 수도 있을까요?
구동 방식 설명표를 붙여 보겠습니다. 기준표의 키가 중복되면 왼쪽 행 하나가 여러 행으로 늘어날 수 있습니다.
drive_labels <- data.frame(
  drv = c("4", "f", "r"),
  drive_name = c("Four-wheel", "Front-wheel", "Rear-wheel"),
  stringsAsFactors = FALSE
)
stopifnot(!anyDuplicated(drive_labels$drv))

labeled <- left_join(cars, drive_labels, by = "drv")
stopifnot(nrow(labeled) == nrow(cars))
stopifnot(!anyNA(labeled$drive_name))
두 검사는 모든 조인에서 행 수가 같아야 한다는 뜻이 아닙니다. 이번 조인의 의도가 다대일 연결이기 때문에 확인하는 것입니다. 일대다 연결을 의도했다면 늘어난 행의 단위와 중복 집계 가능성을 따로 점검해야 합니다.
무엇을 연결해서 기억하면 좋을까요?
표를 바꿀 때마다 행의 의미와 표본 수를 설명할 수 있다면 응용하기 쉬워집니다. 다음에는 종합 분석 프로젝트에서 전처리를 모형과 평가에 연결해 보겠습니다.
직접 해볼까요?
drv대신class로 요약하고 유효 표본이 10개 이상인 집단만 남기세요.- 평균 차이를 비교하기 전에 중앙값의 순서도 같은지 확인해 보세요.
drive_labels에drv = "f"인 행을 하나 더 넣으면 어느 검사가 문제를 발견하나요?
이어서 읽기와 참고 자료
사용한 패키지 버전은 packageVersion("dplyr")와 packageVersion("ggplot2")로 기록할 수 있습니다.
댓글남기기