공개 데이터 하나로 끝내는 R 분석 프로젝트
전처리와 그림, 회귀분석을 각각 배웠다면 하나의 질문에 연결할 수 있을까요? 분석 프로젝트는 여러 함수를 실행하는 것보다 어떤 자료로 언제 무엇을 판단할지 정하는 데서 시작합니다.
이번에는 공개 자료로 질문을 정하고, 시간순으로 검증한 뒤 결과의 한계를 보고하는 단계까지 함께 따라가 보겠습니다.
어떤 시점의 정보로 무엇을 추정할까요?
R에 포함된 공개 자료 airquality로 작은 프로젝트를 진행하겠습니다. 자료는 1973년 5~9월 뉴욕의 일별 공기질·기상 관측 153개로 이루어져 있습니다.
질문은 “그날의 일사량·바람·기온 관측이 확보되었을 때, 오존 농도를 추정할 수 있는가?”입니다. 다음 날의 오존 예보가 아닙니다. 같은 날의 기상 요약이 끝나야 알 수 있는 변수를 써 놓고 사전 예보 성능이라고 주장하면 정보의 시점이 맞지 않습니다.
| 항목 | 이번 분석의 선택 |
|---|---|
| 결과 변수 | Ozone: 오존 농도(ppb) |
| 입력 변수 | Solar.R, Wind, Temp |
| 최종 테스트 | 9월, 관측 정답이 있는 날 |
| 개발·선택 | 5~8월 안에서 시간이 앞으로 흐르는 검증 |
| 비교 대상 | 학습 평균, 기온 회귀, 기온·바람 회귀, 세 변수 회귀 |
| 선택 기준 | 검증 예측을 모은 RMSE |
자료에는 장소·측정 시간·집계 방식이 정해져 있습니다. ?airquality의 설명을 확인하고, 모든 변수가 한 지점에서 같은 순간 측정되었다고 가정하지 마세요.
원자료와 평가 구간은 어떻게 나눌까요?
data(airquality)
raw <- airquality
raw$date <- as.Date(sprintf("1973-%02d-%02d", raw$Month, raw$Day))
raw <- raw[order(raw$date), ]

colSums(is.na(raw))
range(raw$date)
stopifnot(!anyDuplicated(raw$date))

development <- raw[raw$Month <= 8, ]
final_test <- raw[raw$Month == 9, ]
오존은 37개, 일사량은 7개가 누락되어 있습니다. 정답인 오존의 누락은 점수 계산에서 제외하되 몇 개가 빠졌는지 보고합니다. 입력 변수의 누락은 학습 중앙값으로 대체합니다. 원자료를 덮어쓰지 않아야 다른 처리 기준도 비교할 수 있습니다.
여기서는 시간 순서를 유지합니다. 무작위 분할보다 계절 변화나 미래 자료 적용의 어려움을 더 잘 드러낼 수 있습니다. 개발 자료의 EDA와 모델 선택이 끝날 때까지 final_test의 결과는 확인하지 않습니다.
개발 자료에서는 어떤 질문을 확인할까요?
old_par <- par(mfrow = c(1, 2))
plot(development$date, development$Ozone, type = "b", pch = 19,
     col = "#28765b", xlab = "Date", ylab = "Ozone (ppb)")
plot(development$Temp, development$Ozone, pch = 19,
     col = "#28765b", xlab = "Temperature (F)", ylab = "Ozone (ppb)")
par(old_par)

aggregate(is.na(Ozone) ~ Month, data = development, FUN = mean)
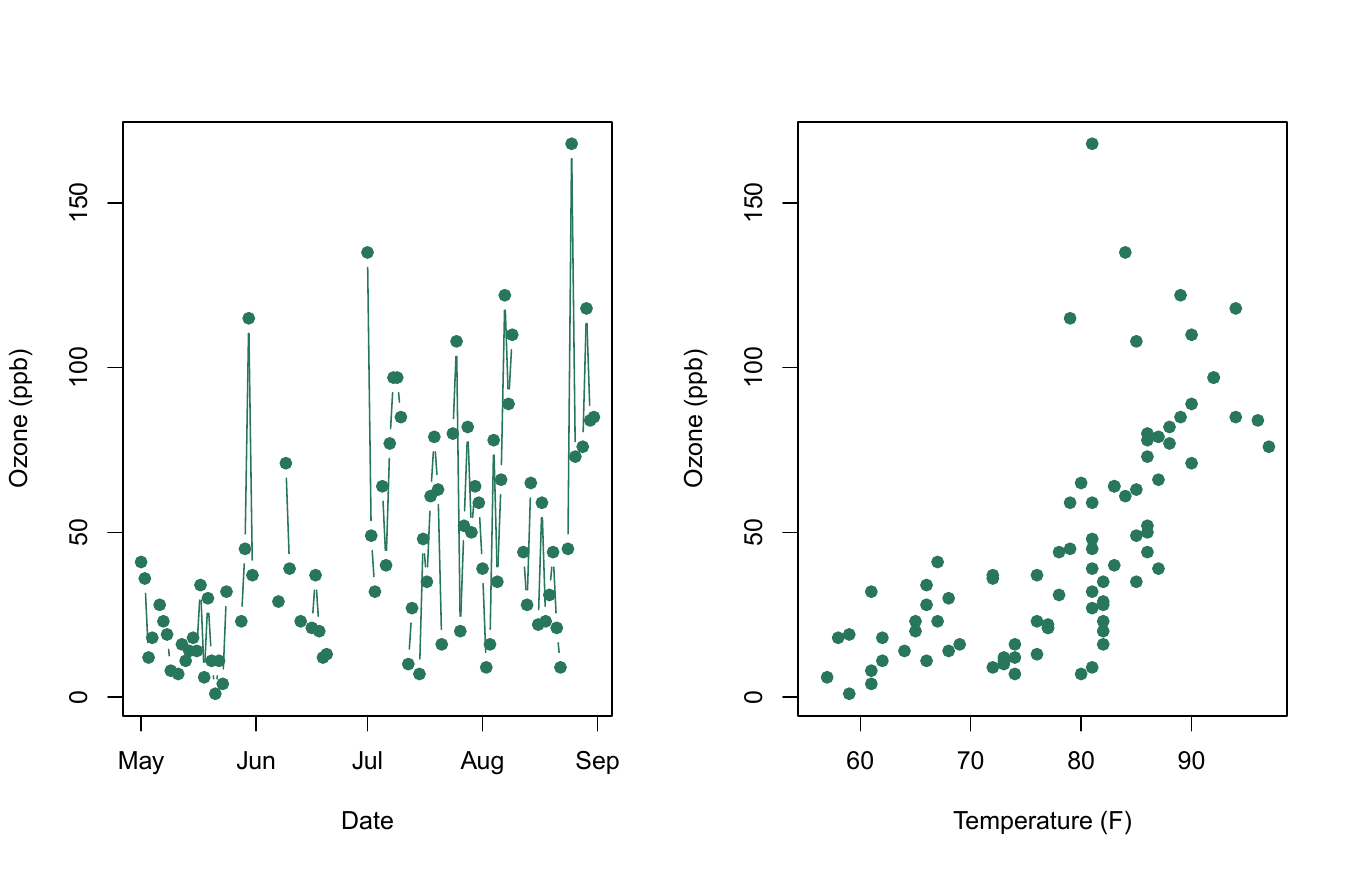
기온과 오존의 관계, 월별 분포, 누락 패턴을 살핍니다. 관측되지 않은 날의 오존 분포는 모르므로, 관측 정답이 있는 날만 평가한다는 점이 한계입니다. 일별 상관은 기온의 인과효과를 뜻하지도 않습니다.
전처리 기준은 어디에서 배워야 할까요?
predictors <- c("Solar.R", "Wind", "Temp")

fit_imputer <- function(training) {
  medians <- sapply(training[predictors], median, na.rm = TRUE)
  if (any(!is.finite(medians))) stop("A predictor has no observed training values")
  medians
}

apply_imputer <- function(new_data, medians) {
  result <- new_data
  for (name in names(medians)) {
    result[[name]][is.na(result[[name]])] <- medians[[name]]
  }
  result
}

formulas <- list(
  mean_only = Ozone ~ 1,
  temperature = Ozone ~ Temp,
  temperature_wind = Ozone ~ Temp + Wind,
  all_three = Ozone ~ Temp + Wind + Solar.R
)
전처리 기준은 예측하려는 기간보다 과거의 학습 행에서 계산합니다. 정답이 없는 학습 행도 입력 변수의 중앙값 계산에는 사용할 수 있지만, 지도학습 모형 적합에서는 제외합니다. 이 선택을 다른 방식으로 바꾸면 결과도 달라질 수 있으므로 기록하세요.
시간을 앞으로 옮기며 후보를 비교해 볼까요?
시점 순서를 지킨 예측값에도 같은 오차 정의를 사용할 수 있습니다. 평가 가능한 날짜 n개의 실제값 y_i와 예측값 ŷ_i로 다음을 계산합니다.
\[\operatorname{RMSE}=\sqrt{\frac1n\sum_{i=1}^{n}(y_i-\widehat y_i)^2}.\]정답이 빠진 날은 점수를 계산할 수 없으므로 n과 제외 날짜 수를 함께 보고합니다. 각 예측을 만들 때 사용할 수 있었던 자료만 사용했는지도 별도로 확인해야 하겠죠.
5월까지로 학습해 6월을, 6월까지로 7월을, 7월까지로 8월을 검증합니다. 각 단계마다 대체 기준과 모형을 새로 적합합니다.
validation_results <- list()
result_id <- 1

for (month in 6:8) {
  training_raw <- development[development$Month < month, ]
  validation_raw <- development[development$Month == month, ]
  medians <- fit_imputer(training_raw)
  training <- apply_imputer(training_raw, medians)
  validation <- apply_imputer(validation_raw, medians)
  training <- training[!is.na(training$Ozone), ]
  validation <- validation[!is.na(validation$Ozone), ]

  for (name in names(formulas)) {
    fit <- lm(formulas[[name]], data = training)
    predicted <- predict(fit, newdata = validation)
    validation_results[[result_id]] <- data.frame(
      model = name, month = month, actual = validation$Ozone,
      predicted = as.numeric(predicted), stringsAsFactors = FALSE
    )
    result_id <- result_id + 1
  }
}

validation_predictions <- do.call(rbind, validation_results)
validation_predictions$squared_error <- with(validation_predictions,
                                            (actual - predicted)^2)
validation_predictions$absolute_error <- with(validation_predictions,
                                             abs(actual - predicted))
scores <- aggregate(cbind(squared_error, absolute_error) ~ model,
                    data = validation_predictions, FUN = mean)
scores$RMSE <- sqrt(scores$squared_error)
scores$MAE <- scores$absolute_error
scores <- scores[order(scores$RMSE), c("model", "RMSE", "MAE")]
scores

selected_name <- as.character(scores$model[1])
selected_name
RMSE는 모든 검증 날짜의 제곱 오차를 모아 평균한 뒤 제곱근을 구했습니다. 월별 RMSE를 단순 평균한 값과는 다를 수 있으므로 집계 방법도 기록합니다.
선택에는 위 검증 점수만 사용합니다. 결과를 본 뒤 후보를 계속 늘리면 검증 점수에도 과적합할 수 있습니다. 이 글에서는 처음 정한 네 후보만 비교합니다.
모형을 고정했다면 9월에서 평가해 볼까요?
final_medians <- fit_imputer(development)
training <- apply_imputer(development, final_medians)
testing <- apply_imputer(final_test, final_medians)
training <- training[!is.na(training$Ozone), ]
testing <- testing[!is.na(testing$Ozone), ]

final_fit <- lm(formulas[[selected_name]], data = training)
test_prediction <- as.numeric(predict(final_fit, newdata = testing))
test_baseline <- rep(mean(training$Ozone), nrow(testing))

evaluate <- function(prediction) {
  c(RMSE = sqrt(mean((testing$Ozone - prediction)^2)),
    MAE = mean(abs(testing$Ozone - prediction)))
}
rbind(Baseline = evaluate(test_baseline), Selected = evaluate(test_prediction))
c(test_days = nrow(final_test), evaluated_days = nrow(testing),
  missing_target = sum(is.na(final_test$Ozone)))

plot(testing$date, testing$Ozone, type = "b", pch = 19,
     col = "#28765b", xlab = "Date", ylab = "Ozone (ppb)",
     ylim = range(c(testing$Ozone, test_prediction, test_baseline)))
lines(testing$date, test_prediction, type = "b", pch = 1, col = "#b76a36")
lines(testing$date, test_baseline, lty = 2, col = "gray50")
legend("topright", c("Observed", "Selected model", "Train mean"),
       col = c("#28765b", "#b76a36", "gray50"), lty = c(1, 1, 2),
       pch = c(19, 1, NA))

sessionInfo()
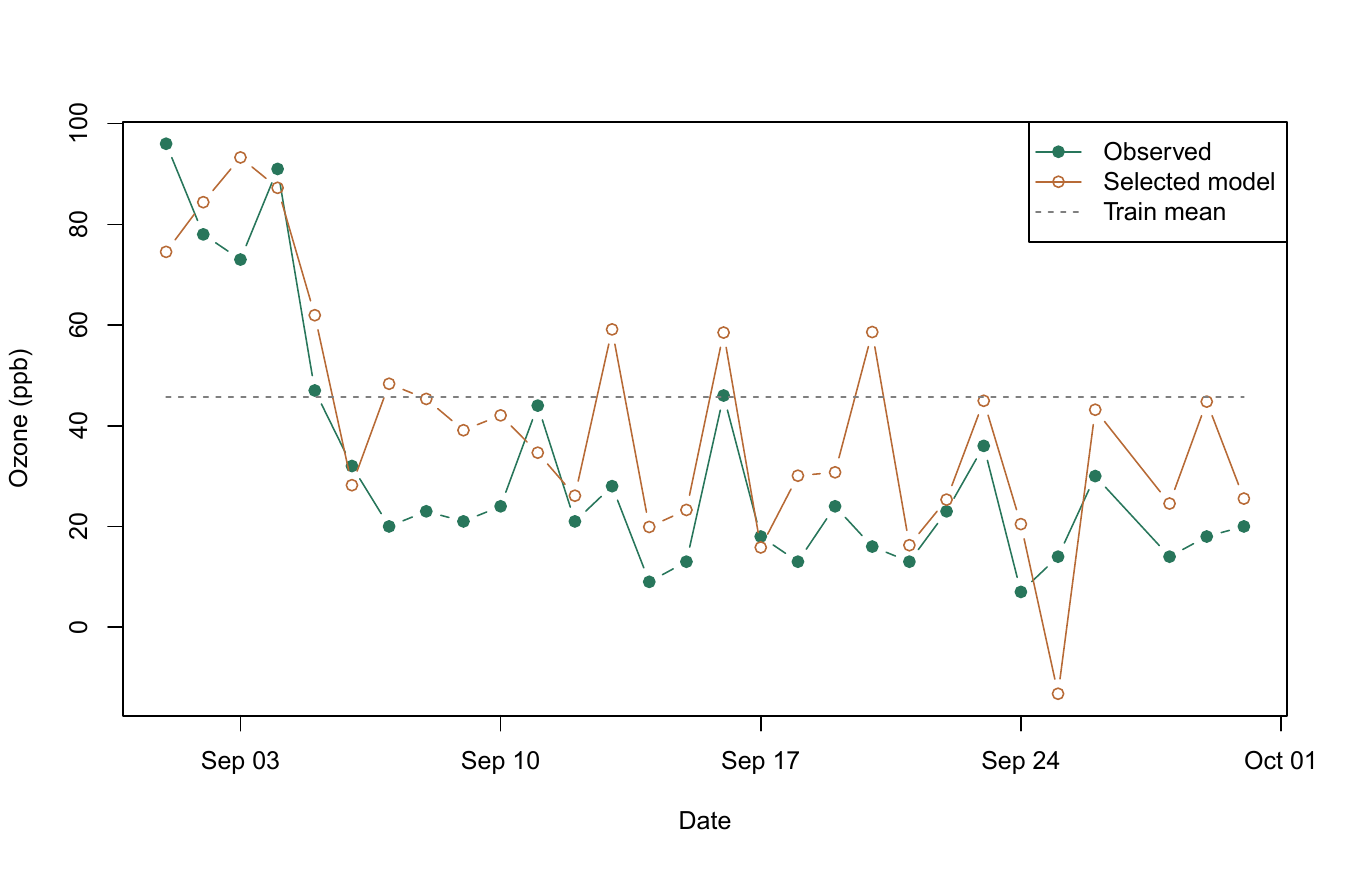
지표 단위는 ppb입니다. 9월의 30일 중 정답이 있는 29일을 평가합니다. 테스트 결과를 확인한 뒤 후보나 전처리를 바꾸면 이 9월 자료는 더 이상 독립적인 최종 테스트 역할을 할 수 없습니다.
이 예제에서는 세 입력 변수를 모두 사용한 all_three가 선택됩니다. 실행 결과를 반올림하면 다음과 같습니다.
| 평가 구간 | 모형 | RMSE (ppb) | MAE (ppb) |
|---|---|---|---|
| 6~8월 검증 예측 합계 | 학습 평균 | 42.11 | 31.88 |
| 6~8월 검증 예측 합계 | 세 변수 회귀 | 27.71 | 20.83 |
| 9월 최종 테스트 | 학습 평균 | 27.67 | 25.06 |
| 9월 최종 테스트 | 세 변수 회귀 | 17.41 | 14.37 |
9월에는 기준 모형보다 오차가 작았지만, 이것이 모든 계절에서의 개선을 증명하지는 않습니다. 오차가 큰 날의 입력 범위와 자료 품질도 확인해야 합니다. 최종 점수가 개발 점수보다 좋아도 더 나빠도 이상하지 않습니다. 월별 날씨와 오존 분포가 달라질 수 있기 때문입니다.
그림에는 0보다 작은 예측도 있습니다. 선형회귀는 농도가 음수가 될 수 없다는 제약을 반영하지 않기 때문입니다. 이는 RMSE가 낮다는 사실과 별개인 모형의 한계입니다. 음수 예측을 자르거나 결과 변수를 변환하는 방법을 검토하려면 그 규칙도 개발 자료에서 비교해야 합니다. 테스트 결과를 본 뒤 사후 조정하고 같은 자료로 성능 개선을 주장하면 안 됩니다.
결과와 함께 어떤 한계를 적어야 할까요?
- 한 도시·한 계절·한 해의 자료이므로 다른 지역과 미래 연도의 성능은 확인하지 않았습니다.
- 같은 날의 관측 변수를 쓰므로 다음 날 사전 예보의 성능으로 해석할 수 없습니다.
- 결과가 관측된 날만 평가하여 정답 누락과 관련된 선택 편향이 있을 수 있습니다.
- 일별 의존성, 비선형 관계와 측정 지점의 차이를 단순 선형회귀가 모두 설명하지는 못합니다.
- 이 예제의 입력 누락 대체는 간단한 기준이며, 대체의 불확실성을 추론에 반영하지 않습니다.
이 한계를 적는 것은 분석이 실패했다는 뜻이 아닙니다. 무엇을 확인했고 어느 범위에서 사용할 수 있는지를 분명히 하는 단계입니다.
무엇을 연결해서 기억하면 좋을까요?
질문·정보 시점·전처리·검증을 연결하면 결과를 어디까지 사용할 수 있는지 설명하기 쉬워집니다. 미래 시점 자체를 예측하는 문제는 시계열 연재의 마지막 프로젝트와 비교해 보세요.
직접 해볼까요?
- 월별 검증 점수를 따로 계산해 특정 달이 전체 선택을 지배하는지 확인해 보세요.
- 최종 테스트를 보기 전에 온도의 제곱항을 후보로 추가하는 실험 계획을 작성하세요. 이미 본 9월을 다시 최종 평가로 쓰면 안 되는 이유도 적으세요.
- 다음 날 예보로 질문을 바꾼다면 입력 변수와 분할을 어떻게 바꾸어야 할까요?
댓글남기기