ggplot2 히스토그램과 밀도 그래프: 구간을 바꾸면 무엇이 달라질까?
같은 자료인데 어떤 그림에는 봉우리가 두 개이고 다른 그림에는 하나만 보일 수 있을까요? 자료가 달라진 것이 아니라 구간이나 매끄러움의 설정이 달라졌을 수 있겠죠. 분포 그림도 선택한 표현 방식의 영향을 받습니다.
히스토그램과 밀도 그래프를 직접 바꾸어 보면서, 관측된 특징과 설정 때문에 달라진 인상을 구분해 보겠습니다.
막대그래프와 무엇이 다른가요?
막대그래프는 구동 방식처럼 범주별 값을 비교합니다. 히스토그램은 연비처럼 수치형인 변수를 구간으로 나누어 분포를 보여줍니다. 구간을 어떻게 정했는지가 결과의 일부가 됩니다.
예를 들어 연비 20~25인 자동차와 25~30인 자동차의 수를 세면 히스토그램입니다. 이 구간의 폭과 시작점을 바꾸면 같은 관측값으로도 봉우리와 빈틈이 다르게 보일 수 있습니다.
구간 너비를 바꾸면 무엇이 달라질까요?
# 처음 한 번만 실행합니다.
install.packages("ggplot2")
library(ggplot2)

p_narrow <- ggplot(mpg, aes(x = hwy)) +
  geom_histogram(binwidth = 1, boundary = 0,
                 fill = "#84b09c", color = "white") +
  labs(x = "Highway fuel economy (mpg)", y = "Count", title = "Bin width: 1") +
  theme_light()

p_wide <- ggplot(mpg, aes(x = hwy)) +
  geom_histogram(binwidth = 5, boundary = 0,
                 fill = "#84b09c", color = "white") +
  labs(x = "Highway fuel economy (mpg)", y = "Count", title = "Bin width: 5") +
  theme_light()

print(p_narrow)
print(p_wide)
mpg는 ggplot2에 포함된 234개 자동차 관측 자료이고, hwy는 고속도로 연비입니다. 별도의 파일을 받을 필요가 없습니다.
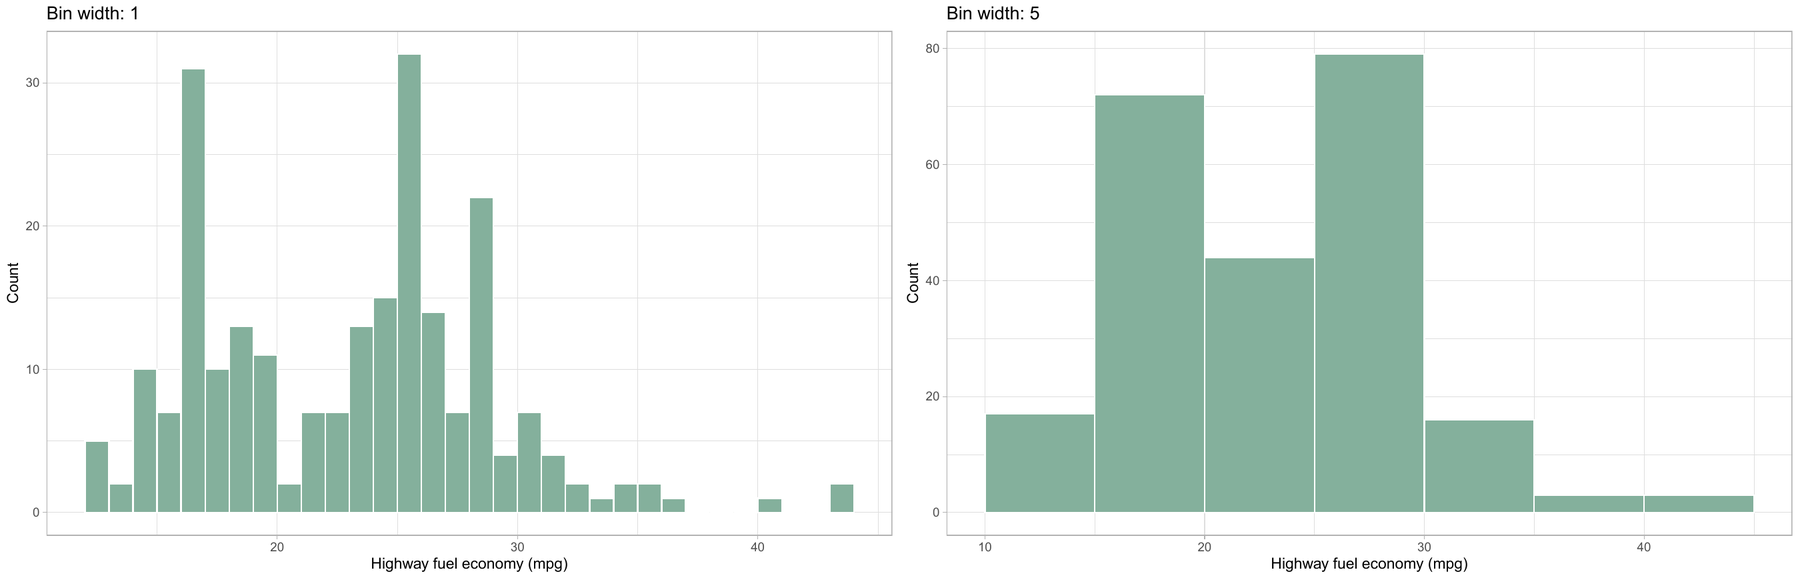
너비 1에서는 세부 빈도와 빈 구간이 드러나고, 너비 5에서는 큰 흐름이 더 단순해집니다. 너비가 작다고 항상 정확한 것도, 매끄럽다고 더 신뢰할 만한 것도 아닙니다. 표본의 크기와 측정 정밀도를 함께 고려하세요.
bins = 20은 대략적인 구간 수를 지정하고 binwidth = 2는 원래 단위로 폭을 지정합니다. boundary는 구간 경계의 위치를 정합니다. 집단끼리 비교할 때에는 같은 폭과 경계를 사용해야 합니다.
개수와 밀도는 어떻게 다를까요?
같은 폭 b의 구간에서 관측값 n개 중 n_j개가 들어갔다고 하겠습니다. 밀도 축의 히스토그램 높이는 다음과 같습니다.
\[\text{높이}_j=\frac{n_j}{nb},\qquad \text{구간 면적}_j=\text{높이}_j\,b=\frac{n_j}{n}.\]막대 높이에 구간 폭을 곱한 면적이 비율입니다. 높이만 확률로 읽지 않는 이유가 여기에 있습니다. 폭이 다른 구간을 쓴다면 각 구간의 폭을 따로 반영해야 합니다.
밀도 그래프의 y축은 관측값의 개수가 아닙니다. 연속 확률밀도에서 확률은 특정 구간 아래의 면적으로 해석합니다. 높이가 1보다 클 수도 있고, 특정 점에서의 높이를 그 값이 나올 확률이라고 읽으면 안 됩니다.
다음은 면적이 1이 되도록 맞춘 히스토그램에 밀도 곡선을 겹친 예입니다. ..density..는 ggplot2 3.1 계열에서도 사용할 수 있는 계산 변수 표기입니다.
ggplot(mpg, aes(x = hwy)) +
  geom_histogram(aes(y = ..density..), binwidth = 2, boundary = 0,
                 fill = "#d5e6dc", color = "white") +
  geom_density(adjust = 1, color = "#28765b", size = 1) +
  geom_rug(alpha = 0.15) +
  labs(x = "Highway fuel economy (mpg)", y = "Density") +
  theme_light()
최근 ggplot2에서는 위 표기에 사용 중단 안내가 나올 수 있습니다. 이 글의 예제는 구버전에서도 실행할 수 있는 문법으로 작성했습니다.
geom_rug()는 관측값을 축 근처의 짧은 선으로 보여줍니다. 표본이 어디에 실제로 존재하는지 곡선과 대조하기 좋습니다. 곡선이 관측 범위 밖으로 조금 이어져도 그곳에 관측값이 있었다는 뜻은 아닙니다.
밀도 곡선은 얼마나 매끄럽게 그릴까요?
ggplot(mpg, aes(x = hwy)) +
  geom_density(aes(color = "adjust = 0.5"), adjust = 0.5, size = 0.8) +
  geom_density(aes(color = "adjust = 1"), adjust = 1, size = 0.8) +
  geom_density(aes(color = "adjust = 2"), adjust = 2, size = 0.8) +
  labs(x = "Highway fuel economy (mpg)", y = "Density", color = "Smoothing") +
  theme_light()
adjust는 기본 대역폭에 곱하는 값입니다. 작게 설정하면 굴곡이 늘어나고, 크게 설정하면 세부 특징이 뭉개질 수 있습니다. 작은 봉우리를 발견했다면 실제 하위 집단의 흔적인지, 표본 변동이나 평활화의 결과인지 확인해 보세요.
표본 수가 다른 집단은 어떻게 비교할까요?
table(mpg$drv)

ggplot(mpg, aes(x = hwy)) +
  geom_histogram(aes(y = ..density..), binwidth = 2, boundary = 0,
                 fill = "#84b09c", color = "white") +
  facet_wrap(~ drv, ncol = 1) +
  labs(x = "Highway fuel economy (mpg)", y = "Density") +
  theme_light()
구동 방식별 표본 수는 사륜 103개, 전륜 106개, 후륜 25개입니다. 밀도 축으로 바꾸면 집단별 분포 모양을 비교하기 쉬워지지만 표본 수의 차이는 숨겨집니다. 그림과 함께 table()의 결과도 제시하세요. facet_wrap()의 축을 자유롭게 바꾸면 집단별 모양이 과장되거나 비슷하게 보일 수 있으므로 여기서는 공통 축을 유지합니다.
바이올린 플롯도 밀도 추정을 이용합니다. 그 폭을 읽을 때 역시 평활화와 표본 수를 고려해야 합니다.
무엇을 연결해서 기억하면 좋을까요?
분포의 봉우리는 구간과 평활화에 얼마나 민감한지 함께 확인하는 편이 좋습니다. 다음에는 산점도와 상관계수로 두 변수의 관계도 숫자와 그림을 함께 읽어 보겠습니다.
직접 해볼까요?
binwidth = 2에서boundary를 0과 1로 바꿔 봉우리의 위치가 어떻게 보이는지 비교하세요.hwy대신 도심 연비cty를 사용해 두 분포의 범위와 치우침을 설명하세요.- 표본이 25개인 후륜 집단에서
adjust = 0.5로 보이는 세부 굴곡을 그대로 해석해도 될까요?
댓글남기기