R 시각화: ggplot2로 막대그래프 그리기
구동 방식별 자동차 수를 비교하고 싶다면 어떤 그림이 좋을까요? 범주마다 막대를 하나씩 두면 크기 차이를 쉽게 볼 수 있겠죠. 이번에는 ggplot2의 기본 구조에서 시작해 개수와 요약값을 구분해 그려 보겠습니다.
막대 높이에 들어가는 값이 무엇인지 먼저 정하는 것이 중요한데요. 원자료의 개수와 미리 계산한 평균은 서로 다른 질문에 답하기 때문입니다.
어떤 자료로 시작할까요?
EDA의 기본 개념에 이어 R의 ggplot2로 범주별 값을 비교해 보겠습니다. 아래 코드는 처음부터 순서대로 실행하세요.
# 패키지 설치는 처음 한 번만 필요합니다.
install.packages(c("ggplot2", "dplyr"))

library(ggplot2)
library(dplyr)
예제 데이터 mpg는 ggplot2에 들어 있는 자동차 데이터입니다. 234개 행과 11개 변수가 있으며, 이 글에서는 다음 변수를 사용합니다.
| 변수 | 의미 |
|---|---|
drv |
구동 방식: f 전륜, r 후륜, 4 사륜 |
fl |
연료 종류 |
manufacturer |
제조사 |
hwy |
고속도로 연비(miles per gallon, mpg) |
hwy는 값이 클수록 같은 연료로 더 멀리 이동한다는 뜻입니다. km/L와는 단위가 다릅니다.
ggplot2는 어떤 순서로 그림을 만들까요?
ggplot()에서 데이터와 축을 지정하고, +로 그래프와 꾸미기 요소를 하나씩 추가합니다.
ggplot(data = mpg, aes(x = drv)) +
  geom_bar() +
  theme_light()
data = mpg: 사용할 데이터입니다.aes(x = drv): x축에 구동 방식을 놓습니다.geom_bar(): 각 범주의 행 수를 세어 막대 높이로 표시합니다.theme_light(): 배경과 격자 스타일을 바꿉니다.

색상과 범주 순서는 어떻게 바꿀까요?
fill = drv를 aes() 안에 넣으면 구동 방식에 따라 색을 다르게 채웁니다. 하나의 고정 색을 쓰려면 geom_bar(fill = "steelblue")처럼 aes() 밖에 지정하세요.
ggplot(mpg, aes(x = drv, fill = drv)) +
  geom_bar(width = 0.7) +
  scale_x_discrete(limits = c("f", "4", "r")) +
  labs(x = "구동 방식", y = "관측값 수", fill = "구동 방식") +
  theme_light()
scale_x_discrete(limits = ...)는 범주의 순서를 정합니다. 목록에 없는 범주는 제외되므로, 의도하지 않게 데이터를 빠뜨리지 않도록 주의하세요.
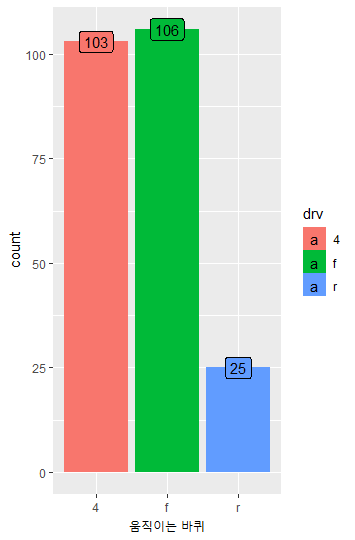
막대 위에 개수를 함께 표시할까요?
after_stat(count)는 geom_bar()가 계산한 개수를 라벨로 사용합니다.
ggplot(mpg, aes(x = drv, fill = drv)) +
  geom_bar(width = 0.7) +
  geom_text(stat = "count", aes(label = after_stat(count)), vjust = -0.3) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.1))) +
  labs(x = "구동 방식", y = "관측값 수") +
  theme_light() +
  theme(legend.position = "none")
한 범주 안의 여러 집단은 어떻게 비교할까요?
집단의 크기가 다르면 개수만으로 구성을 비교하기 어려울 수 있겠죠. 전체 유효 관측값이 n개이고 범주 j가 n_j개라면 비율은 다음과 같습니다.
\[p_j=\frac{n_j}{n}.\]이때 분모가 전체 자료인지, 각 구동 방식 안의 자료인지에 따라 다른 비율이 됩니다. 그림의 축과 설명에 비교 기준을 함께 적어 보세요.
구동 방식별로 연료 종류를 비교하려면 fill = fl을 사용합니다.
ggplot(mpg, aes(x = drv, fill = fl)) +
  geom_bar(width = 0.7, position = "dodge") +
  labs(x = "구동 방식", y = "관측값 수", fill = "연료 종류") +
  theme_light()
position 값 |
표현 방식 | 적합한 비교 |
|---|---|---|
"dodge" |
막대를 나란히 배치 | 집단별 개수 |
"stack" |
막대를 위로 쌓기 | 총개수와 구성 |
"fill" |
전체 높이를 1로 맞추기 | 범주 내 구성 비율 |

이미 계산한 평균은 어떻게 그릴까요?
geom_col()은 y축에 지정한 값을 그대로 막대 높이로 사용합니다. 구동 방식과 제조사별 평균 연비를 비교하려면 먼저 집단별 평균을 계산합니다. 원자료를 그대로 겹쳐 그리면 집단의 대표값을 비교하기 어렵습니다.
mpg_summary <- mpg %>%
  group_by(drv, manufacturer) %>%
  summarise(mean_hwy = mean(hwy, na.rm = TRUE), .groups = "drop")

ggplot(mpg_summary, aes(x = drv, y = mean_hwy, fill = manufacturer)) +
  geom_col(position = "dodge") +
  labs(x = "구동 방식", y = "평균 고속도로 연비(mpg)", fill = "제조사") +
  theme_light()
geom_bar(stat = "identity")도 지정한 y값을 그리지만, 이 목적에는 geom_col()이 더 간결합니다. 연비를 모두 더한 값은 해석하기 어려우므로, 평균이나 분포를 비교하는 편이 목적에 맞습니다.
무엇을 연결해서 기억하면 좋을까요?
범주별 행 수에는 geom_bar(), 미리 요약한 값에는 geom_col()을 쓰면 목적이 선명해집니다. 다음으로 dplyr 전처리에서 그림에 넣을 요약표를 직접 만들어 보겠습니다.
직접 해볼까요?
mpg의 class별 관측값 개수를 그리고, 막대 위에 개수를 표시해 보세요. x축을 class로 바꾸되 y축을 직접 지정할 필요는 없습니다.
이어서 읽기와 참고 자료
그림은 기존 예시입니다. ggplot2 버전과 테마, 글꼴에 따라 실행 화면은 달라질 수 있습니다.
댓글남기기