시계열 분석 12. 미래를 보지 않고 예측 모형을 고를 수 있을까요?
실제로 미래를 예측한다면 자료를 어떻게 나눌까요?
1958년 말에 앞으로 2년의 승객 수를 예측한다고 생각해 보겠습니다. 이때 1959년의 자료를 보고 계절 패턴을 고를 수는 없겠죠. 이번 글에서는 지금까지 배운 내용을 모아, 정보의 시간 순서를 지키는 작은 프로젝트를 완성하겠습니다.
자료는 1949~1960년의 월별 국제 항공 승객 수인 AirPassengers입니다. 1958년까지의 120개월을 개발에 사용하고, 마지막 24개월은 최종 평가에만 사용합니다. 전체 자료가 144개월인 작은 역사 자료이므로 현실의 모든 항공 수요를 대표하는 예제로 읽지는 말아 주세요.
비교할 후보와 기준을 먼저 정해 볼까요?
| 항목 | 이번 분석에서 정한 내용 |
|---|---|
| 질문 | 월별 관측이 끝난 뒤 향후 승객 수를 예측 |
| 후보 1 | 마지막 연도의 같은 달 값을 반복하는 계절 naïve |
| 후보 2 | 로그 SARIMA(0,1,1)(0,1,1)[12]의 평균 근사 예측 |
| 개발 검증 | 84·96·108개월까지 각각 학습해 다음 12개월 예측 |
| 선택 기준 | 세 검증 구간의 예측을 모은 RMSE |
| 최종 평가 | 120개월 전체로 다시 적합하고 이후 24개월 평가 |
검증 horizon은 12개월, 최종 horizon은 24개월로 다릅니다. 따라서 2년 앞의 성능까지 충분히 검증한 설계는 아니라는 한계도 기록하겠습니다. 더 긴 자료가 있다면 실제 의사결정 horizon을 닮은 검증 구간을 확보하는 편이 좋겠죠.
같은 함수로 후보를 예측하기
data(AirPassengers)
development <- window(AirPassengers, end = c(1958, 12))
final_test <- window(AirPassengers, start = c(1959, 1))

forecast_candidate <- function(training, horizon, model) {
  if (model == "seasonal_naive") {
    return(rep(tail(as.numeric(training), 12), length.out = horizon))
  }
  fit <- arima(log(training), order = c(0, 1, 1),
               seasonal = list(order = c(0, 1, 1), period = 12), method = "ML")
  f <- predict(fit, n.ahead = horizon)
  exp(as.numeric(f$pred) + 0.5 * as.numeric(f$se)^2)
}
로그 변환은 양수인 승객 수와 수준에 따른 변동을 생각해 개발 단계에서 정한 선택입니다. 예측을 되돌릴 때는 SARIMA 글의 정규 근사 평균 보정을 사용했습니다. 예측 전에 최종 테스트 결과에 맞춰 변환을 바꾸지 않습니다.
예측 원점을 앞으로 옮겨 보겠습니다
rolling-origin 검증은 학습이 끝나는 시점을 앞으로 옮기며 새로 예측하는 방법입니다. 여기서는 창의 시작은 고정하고 끝을 늘리는 expanding window를 사용합니다.
models <- c("seasonal_naive", "sarima")
validation <- list()
i <- 1
for (origin in c(84, 96, 108)) {
  training <- ts(as.numeric(development)[1:origin], start = c(1949, 1), frequency = 12)
  actual <- as.numeric(development)[(origin + 1):(origin + 12)]
  seasonal_scale <- mean(abs(diff(as.numeric(training), lag = 12)))
  for (model in models) {
    predicted <- forecast_candidate(training, 12, model)
    validation[[i]] <- data.frame(
      model = model, origin = origin, horizon = 1:12,
      squared_error = (actual - predicted)^2,
      absolute_error = abs(actual - predicted),
      scaled_error = abs(actual - predicted) / seasonal_scale
    )
    i <- i + 1
  }
}

validation <- do.call(rbind, validation)
summary_scores <- aggregate(cbind(squared_error, absolute_error, scaled_error) ~ model,
                            data = validation, FUN = mean)
summary_scores$RMSE <- sqrt(summary_scores$squared_error)
summary_scores$MAE <- summary_scores$absolute_error
summary_scores$MASE <- summary_scores$scaled_error
summary_scores <- summary_scores[order(summary_scores$RMSE), c("model", "RMSE", "MAE", "MASE")]
summary_scores
selected <- as.character(summary_scores$model[1])
각 예측에는 그 원점 이전의 자료만 들어갑니다. 실제로 관측된 검증 값을 다음 모형의 학습에 사용하는 것은 시간이 흐른 뒤라면 가능한 일입니다. 다만 한 원점에서 12개월을 예측하는 도중에 미래의 실제값을 끼워 넣지는 않습니다.
MASE는 절대 오차를 학습 자료의 계절 naïve 오차 규모로 나누어 비교합니다.
\[q=\frac{1}{n-m}\sum_{t=m+1}^{n}|x_t-x_{t-m}|, \qquad \operatorname{MASE}=\frac{\operatorname{mean}|e_h|}{q}.\]여기서는 각 원점의 학습 자료로 계산한 q를 사용했습니다. q가 0인 자료에는 이 정의를 그대로 쓸 수 없습니다. MASE가 1 미만이라는 말도 평가 구간의 계절 naïve보다 항상 좋다는 뜻은 아닙니다. 분모는 학습 기간의 오차 규모이기 때문입니다.
마지막 24개월은 이제 한 번 평가해 볼까요?
prediction <- forecast_candidate(development, 24, selected)
baseline <- forecast_candidate(development, 24, "seasonal_naive")
actual <- as.numeric(final_test)
score <- function(p) c(RMSE = sqrt(mean((actual - p)^2)), MAE = mean(abs(actual - p)))
selected
rbind(Seasonal_naive = score(baseline), Selected = score(prediction))

plot(AirPassengers, ylab = "Passengers (thousands)", main = "Final 24-month evaluation",
     ylim = range(c(AirPassengers, prediction, baseline)))
lines(as.numeric(time(final_test)), prediction, col = "#b56535", lwd = 2)
lines(as.numeric(time(final_test)), baseline, col = "#416c9b", lty = 2)
abline(v = 1959, lty = 3)
legend("topleft", c("Observed", "Selected model", "Seasonal naive"),
       col = c("black", "#b56535", "#416c9b"), lty = c(1, 1, 2), bty = "n")
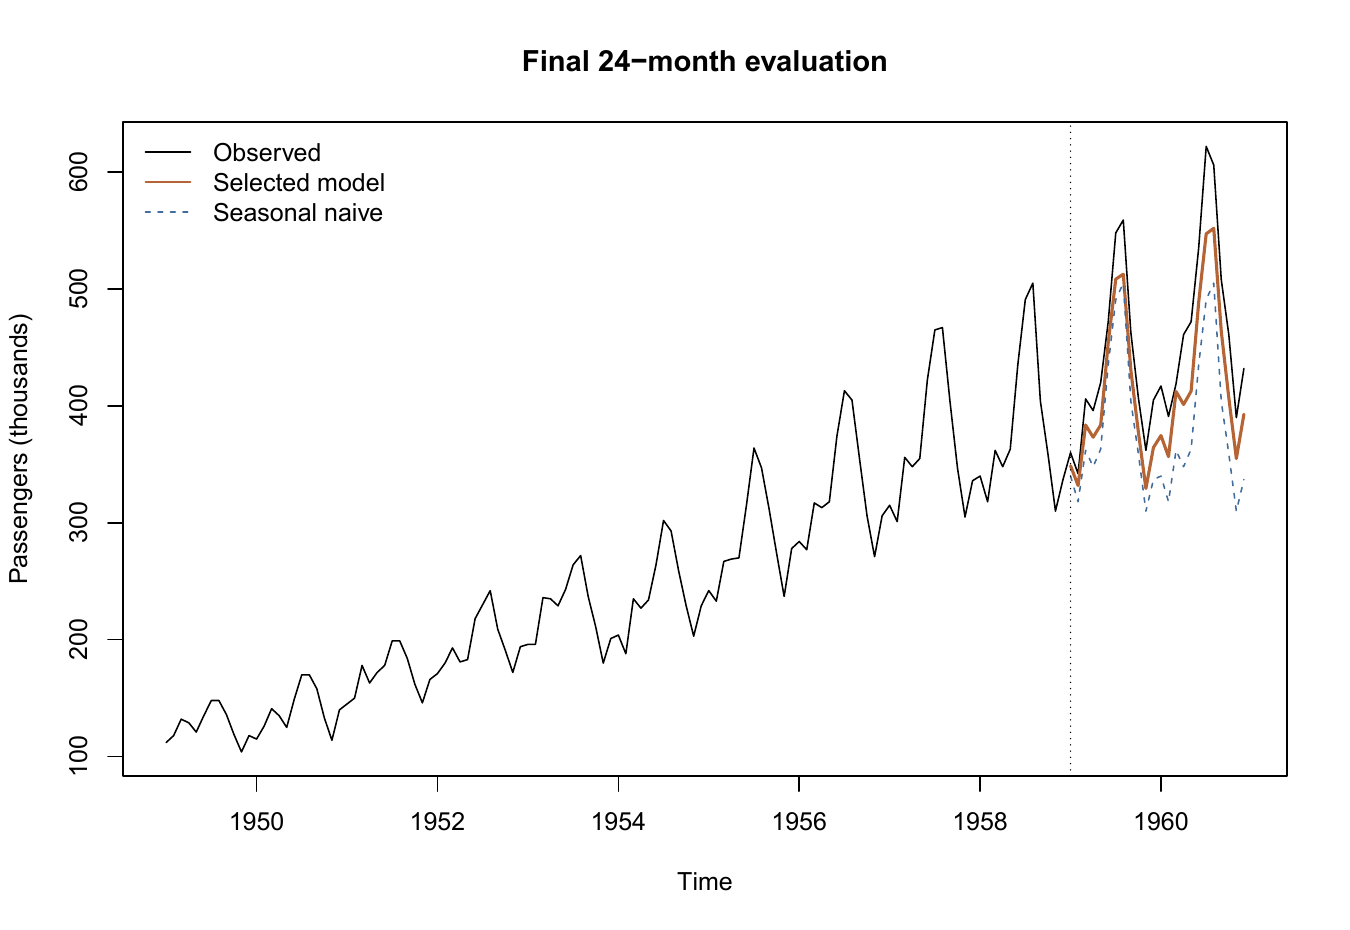
지표 단위는 천 명입니다. 검증에서 고른 이름과 테스트 점수를 함께 기록하면 어떤 선택을 평가했는지 알 수 있습니다. 테스트 결과를 본 뒤 후보를 늘려 다시 고른다면 새로운 평가 자료가 필요하겠죠.
실행한 결과를 반올림하면 다음과 같습니다. 개발 검증의 RMSE로 SARIMA를 선택했고, 최종 24개월에서도 이 후보를 그대로 평가했습니다.
| 구간 | 후보 | RMSE (천 명) | MAE (천 명) |
|---|---|---|---|
| 개발 검증 36개 예측 | 계절 naïve | 36.75 | 32.33 |
| 개발 검증 36개 예측 | SARIMA | 18.93 | 13.63 |
| 최종 테스트 24개월 | 계절 naïve | 76.99 | 71.25 |
| 최종 테스트 24개월 | 선택한 SARIMA | 40.64 | 37.14 |
이 결과는 특정 자료·후보·분할에서의 비교입니다. SARIMA라는 이름 자체가 다른 자료에서도 더 좋은 성능을 보장하는 것은 아닙니다.
어떤 한계를 남겨야 할까요?
이 예제의 개발 검증 구간은 세 개뿐입니다. 월별 오차는 서로 독립이라고 보기 어렵고, 검증·테스트 구간은 특정 역사 시기에 해당합니다. 모형이 잘 맞아도 구조 변화나 외부 충격이 있는 미래까지 보장하지는 않습니다.
또한 여기서는 점 예측을 비교했습니다. 의사결정에 예측구간이 필요하다면 잔차와 구간 진단을 더하고, horizon별 구간 포함률과 폭도 별도로 평가해야 합니다. 관측되지 않은 외생 변수를 이미 아는 것처럼 넣지 않는 원칙도 같습니다.
연재를 마치며 무엇을 연결하면 좋을까요?
백색소음에서 시작해 정상성·ACF·ARMA·차분·계절 모형을 살펴봤습니다. 개별 모형 이름을 외우는 것보다 어떤 정보로 언제 예측하고, 그 선택을 어떻게 평가했는지 설명할 수 있는 것이 중요합니다. 다른 자료에서도 같은 질문을 순서대로 적용해 보세요.
직접 생각해 보기와 참고 자료
- 예측 원점을 매달 옮기면 평가 자료는 늘어나지만, 겹치는 오차를 독립 표본처럼 취급해도 될까요?
- 이 자료에 최종 테스트 24개월을 유지하면서 24개월 horizon의 개발 검증을 추가하면, 가능한 원점과 학습 기간이 어떻게 줄어들까요?
댓글남기기