R 결측값 처리: NA를 지우기 전에 확인할 것
빈칸이 있는 행을 모두 지우면 깔끔한 자료가 될까요? 숫자는 정리되더라도 어떤 사람들이 빠졌는지에 따라 결론이 달라질 수 있겠죠. 결측값(missing data)은 채우는 방법보다 빠진 과정을 먼저 생각해야 합니다.
누락의 위치와 비율을 확인한 뒤, 삭제와 대체가 표본과 분포를 어떻게 바꾸는지 비교해 보겠습니다.
NA가 있다는 이유만으로 행을 지워도 될까요?
EDA에서 결측값을 찾았다면 다음은 처리 방법을 정할 차례입니다. 설문에서 소득 응답을 하지 않은 사람과 센서 고장으로 값이 기록되지 않은 사례는 모두 NA로 표시될 수 있지만, 발생 과정과 분석상의 의미는 다릅니다.
R에서 NA는 관측되지 않은 값입니다. 0은 관측한 값이고, 문자 "NA"는 문자열이므로 구분해야 합니다. 빈 문자열과 -999 같은 코드는 자료 설명을 확인한 뒤 결측값으로 바꿔야 합니다.
결측 현황은 어떻게 세어 볼까요?
변수마다 관측 여부를 R_i로 표시해 볼까요? 관측되면 1, 빠졌으면 0으로 두면 결측률은 다음과 같습니다.
\[\text{결측률}=1-\frac{\sum_{i=1}^{n}R_i}{n}.\]분모 n은 해당 변수의 관측 여부를 확인할 전체 사례 수입니다. 이 비율이 같아도 어느 집단에서 빠졌는지가 다르면 분석상의 영향은 달라질 수 있습니다.
아래 예제는 설명을 위해 만든 가상 자료입니다. 별도 패키지 없이 순서대로 실행할 수 있습니다.
survey <- data.frame(
  id = 1:8,
  group = rep(c("A", "B"), each = 4),
  age = c(25, 30, NA, 35, 40, NA, 50, 45),
  income = c(200, 220, NA, 260, 400, NA, NA, 500)
)

data.frame(
  variable = names(survey),
  missing_n = colSums(is.na(survey)),
  missing_pct = 100 * colMeans(is.na(survey))
)
sum(complete.cases(survey))
나이는 2개, 소득은 3개가 빠져 있습니다. 완전한 행은 5개입니다. 두 변수에서 누락된 행이 일부 겹치므로 결측 개수를 더한 5개 행이 삭제되는 것은 아닙니다.
survey$age == NA로는 결측 여부를 판별할 수 없습니다. is.na(survey$age)를 사용하세요. 전체 결측률만 보면 집단 간 차이를 놓칠 수 있으므로 다음 표도 확인합니다.
aggregate(is.na(income) ~ group, data = survey, FUN = mean)
table(survey$group, is.na(survey$income))
A의 소득 누락률은 25%, B는 50%입니다. 이 패턴만으로 누락 원인을 확정할 수는 없지만, 어느 집단의 정보가 더 많이 빠졌는지 알 수 있습니다.
누락 원인에 따라 어떤 가정이 달라질까요?
| 구분 | 의미 | 생각해 볼 예 |
|---|---|---|
| MCAR | 누락이 관측·미관측 값과 무관 | 무작위로 일부 설문지가 분실됨 |
| MAR | 관측된 변수를 조건으로 하면 누락이 미관측 값에 의존하지 않음 | 관측된 연령을 고려하면 소득 누락이 소득 자체와 무관함 |
| MNAR | 관측된 변수를 고려해도 누락이 미관측 값에 의존함 | 같은 연령 안에서도 소득이 높을수록 응답을 피함 |
MAR와 MNAR를 관측 자료만으로 완전히 구별하기는 어렵습니다. 수집 과정, 응답 안내, 장비 기록 등 자료 밖의 정보가 필요합니다. 결측률이 낮다고 해서 편향도 반드시 작은 것은 아닙니다.
삭제와 평균 대체는 어떤 차이를 만들까요?
complete_data <- survey[complete.cases(survey), ]
observed_income <- survey$income[!is.na(survey$income)]

filled_data <- survey
filled_data$income[is.na(filled_data$income)] <- mean(observed_income)

comparison <- data.frame(
  method = c("Observed income", "Complete rows", "Mean imputation"),
  n = c(length(observed_income), nrow(complete_data), nrow(filled_data)),
  mean_income = c(mean(observed_income), mean(complete_data$income),
                  mean(filled_data$income)),
  sd_income = c(sd(observed_income), sd(complete_data$income),
                sd(filled_data$income))
)
round(comparison[, -1], 2)
comparison$method

boxplot(observed_income, filled_data$income,
        names = c("Observed", "Mean imputed"),
        ylab = "Income (10,000 KRW)", col = c("#86b5a1", "#e5bb80"))
관측된 소득은 평균 316, 표준편차 약 129.15입니다. 평균 대체 후 평균은 316으로 같지만 표준편차는 약 97.63으로 줄어듭니다. 평균을 보존했다는 이유로 원래의 정보가 복원된 것은 아닙니다.
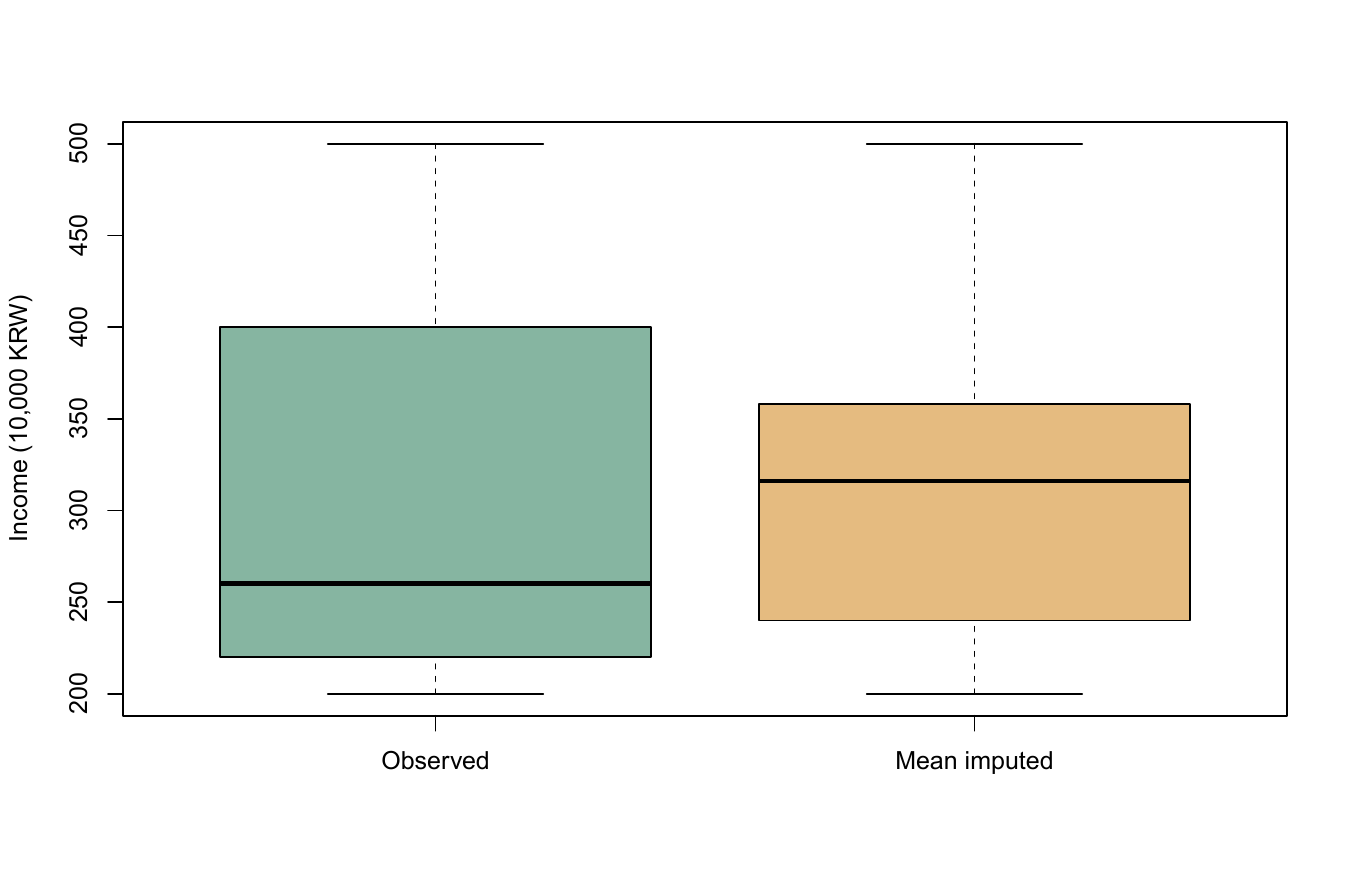
이 자료에서는 소득이 있는 5개 행이 다른 변수까지 완전한 5개 행과 우연히 같습니다. 실제 자료에서는 분석에 필요하지 않은 열까지 포함해 na.omit()을 적용하면 불필요하게 표본을 잃을 수 있습니다. 분석에 쓰는 열과 삭제 기준을 먼저 정하세요.
실무에서는 어떻게 선택하나요?
단순 평균 대체는 비교 기준으로는 유용하지만 분산과 변수 관계를 왜곡하고 불확실성을 과소평가할 수 있습니다. 집단별 대체 역시 집단 안의 차이를 복원하지는 못합니다. 통계적 추론이 목적이라면 다중 대체와 대체 모형의 가정을 검토하고, 여러 처리 방법에서 결론이 유지되는지 비교하세요.
예측 모델에서는 데이터를 먼저 나눕니다. 학습 데이터로 대체값을 계산하고, 검증·테스트 데이터에는 그 값을 그대로 적용해야 합니다. 테스트 데이터의 평균까지 쓰면 데이터 누수가 생깁니다. 정답 변수의 누락은 입력 변수와 구분해서 처리해야 합니다.
분석 결과에는 원래 표본 수, 변수별 누락 수, 제외된 사례 수, 사용한 대체 방법과 가정을 함께 적습니다. “결측치를 처리했다”는 문장만으로는 분석 과정을 재현할 수 없습니다.
무엇을 연결해서 기억하면 좋을까요?
결측률과 대체 후 평균만으로 처리가 적절했다고 결론 내리기는 어렵습니다. 비교에 남은 표본을 확인했다면 이상치 처리에서 특이한 값도 같은 원칙으로 살펴보겠습니다.
직접 해볼까요?
income의 결측값을 중앙값으로 대체하고 평균·표준편차를 다시 계산하세요.- 삭제 전후 A와 B의 인원 비율을 비교하세요.
- B 집단의 누락된 소득이 관측값보다 컸다면, 단순 평균 대체가 전체 평균을 어느 방향으로 움직일지 생각해 보세요.
이어서 읽기와 참고 자료
예제의 소득은 가상 값이며 단위는 만 원입니다. 사용하는 R 버전은 sessionInfo()로 함께 기록하세요.
댓글남기기