시계열 분석 10. SARIMA는 계절 패턴을 어떻게 예측할까요?
작년 같은 달의 정보도 사용할 수 있을까요?
월별 매출에는 바로 지난달뿐 아니라 작년 같은 달과의 관계도 있을 수 있습니다. ARIMA에 이런 계절 시차의 구조를 더한 모형을 계절 ARIMA(seasonal ARIMA, SARIMA)라고 말합니다.
계절성 글에서 주기를 먼저 확인했는데요. 주기가 12라는 이유만으로 계절 차수까지 자동 결정되는 것은 아닙니다.
일곱 숫자는 각각 무엇일까요?
SARIMA$(p,d,q)(P,D,Q)_m$에서 소문자는 일반 시차의 AR·차분·MA 차수입니다. 대문자는 계절 시차의 차수이고, m은 한 계절 주기의 관측 개수입니다.
\[\phi(B)\Phi(B^m)(1-B)^d(1-B^m)^D X_t =\theta(B)\Theta(B^m)a_t.\]예를 들어 $(0,1,1)(0,1,1)_{12}$는 일반 차분 1번과 계절 차분 1번을 적용하고, 그 결과에 일반 MA(1)과 계절 MA(1)을 둡니다. MA 다항식을 곱하면 다음이 됩니다.
\[(1+\theta B)(1+\Theta B^{12}) =1+\theta B+\Theta B^{12}+\theta\Theta B^{13}.\]따라서 시차 13에도 항이 생깁니다. 독립적으로 계수 세 개를 더한 모형과는 구조가 다르겠죠.
R에서 모형을 적합해 볼까요?
data(AirPassengers)
training <- window(AirPassengers, end = c(1958, 12))
testing <- window(AirPassengers, start = c(1959, 1))
fit <- arima(log(training), order = c(0, 1, 1),
             seasonal = list(order = c(0, 1, 1), period = 12), method = "ML")
coef(fit)
forecast <- predict(fit, n.ahead = 24)
이 후보는 설명을 위해 미리 정했습니다. 실제 모형 선택에서는 여러 후보를 개발 자료 안에서 시간순으로 비교합니다. 계절 차분을 적용한 뒤의 일반·계절 AR 구조는 정상성을, MA 구조는 가역성을 따로 확인해야 합니다.
로그 예측을 지수로 바꾸면 평균일까요?
로그 척도의 예측을 $m_h$, 예측 분산을 $s_h^2$라고 하겠습니다. 조건부 예측분포를 정규분포로 근사하면 원래 척도에서 다음을 얻습니다.
\[\operatorname{Median}(X_{t+h}\mid\mathcal F_t)\approx e^{m_h}, \qquad E[X_{t+h}\mid\mathcal F_t]\approx e^{m_h+s_h^2/2}.\]단순히 exp()를 취한 점은 평균이 아니라 중앙값에 대응합니다. 지수 함수가 비선형이기 때문에 평균을 되돌리는 방법도 달라지는데요. 평균 예측이 필요한지 중앙값 예측이 필요한지에 따라 구분하세요. 위 보정도 정규 근사와 추정한 예측 분산에 의존합니다.
log_point <- as.numeric(forecast$pred)
log_se <- as.numeric(forecast$se)
median_prediction <- exp(log_point)
mean_prediction <- exp(log_point + 0.5 * log_se^2)
lower <- exp(log_point - qnorm(0.975) * log_se)
upper <- exp(log_point + qnorm(0.975) * log_se)

plot(AirPassengers, ylim = range(c(AirPassengers, lower, upper)),
     ylab = "Passengers (thousands)", main = "Seasonal ARIMA forecast")
polygon(c(time(testing), rev(time(testing))), c(lower, rev(upper)),
        col = adjustcolor("#8db8a3", alpha.f = 0.4), border = NA)
lines(testing, col = "#333333")
lines(as.numeric(time(testing)), mean_prediction, col = "#b56535", lwd = 2)
lines(as.numeric(time(testing)), median_prediction, col = "#416c9b", lty = 2)
abline(v = 1959, lty = 3)
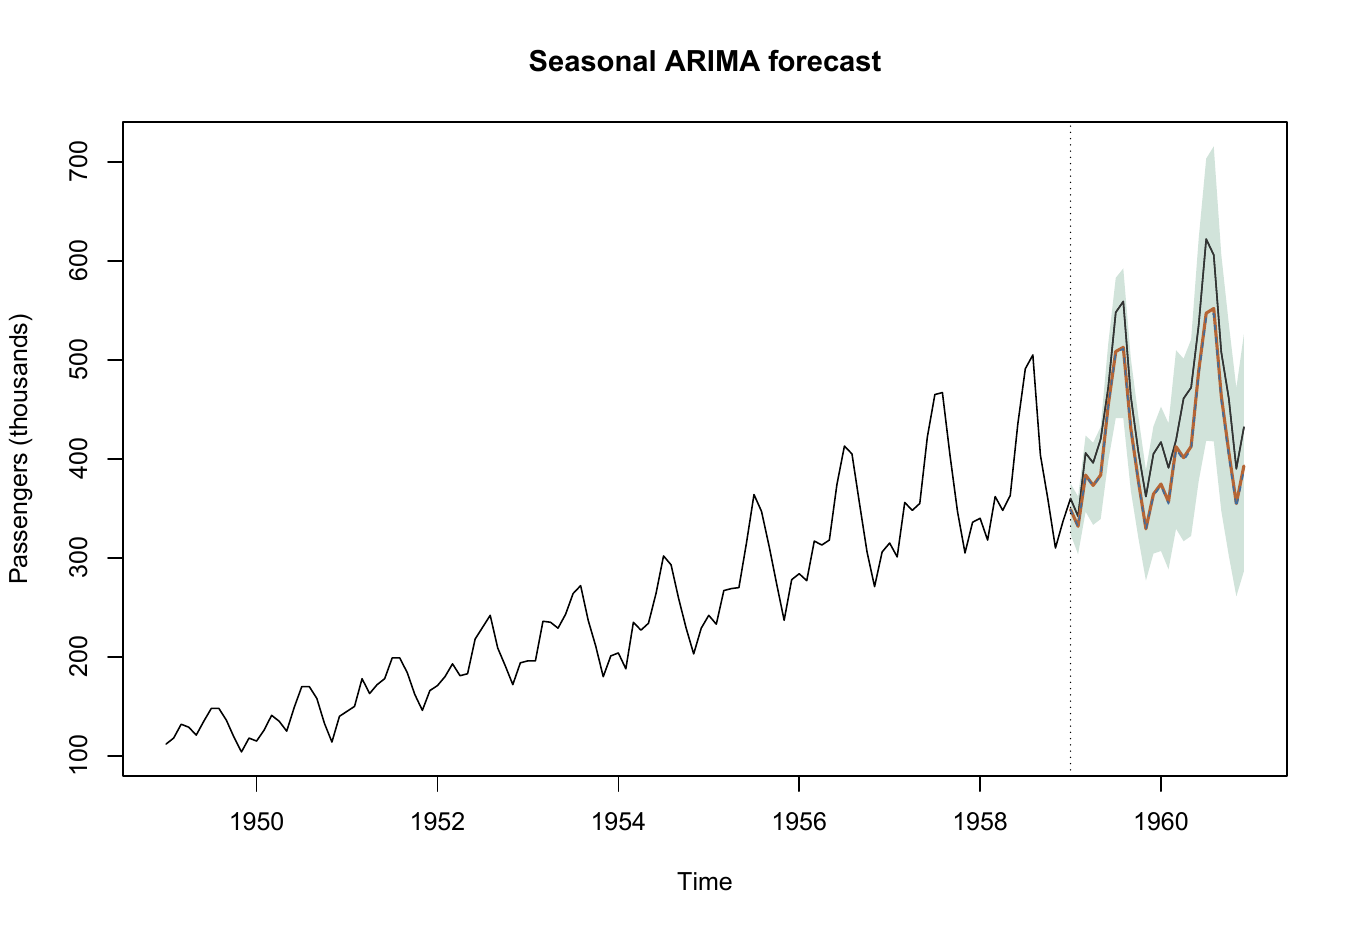
로그 척도의 구간 끝점을 지수로 되돌리면 원래 단위에서는 비대칭 구간이 됩니다. 평균 점 예측에 원래 단위의 표준오차를 임의로 더하고 빼는 방법과 다릅니다.
계절 naïve보다 좋아졌을까요?
seasonal_naive <- rep(tail(as.numeric(training), 12), length.out = 24)
mae <- function(p) mean(abs(as.numeric(testing) - p))
rmse <- function(p) sqrt(mean((as.numeric(testing) - p)^2))
data.frame(model = c("Seasonal naive", "SARIMA mean", "SARIMA median"),
           MAE = c(mae(seasonal_naive), mae(mean_prediction), mae(median_prediction)),
           RMSE = c(rmse(seasonal_naive), rmse(mean_prediction), rmse(median_prediction)))
계절 naïve는 마지막 12개월의 패턴을 반복합니다. 이 자료는 상승 추세도 있어 단순 반복이 불리할 수 있지만, 비교 기준을 생략하는 것보다 무엇을 개선했는지 알기 쉽습니다. 이 테스트를 본 뒤 같은 자료에 맞춰 모형을 다시 고르면 최종 평가로서의 역할은 달라집니다.
다음에는 무엇을 배우면 좋을까요?
예측선이 자연스러워 보여도 남아 있는 의존성과 구간의 가정을 확인해야 합니다. 다음 글에서는 잔차 진단과 예측구간을 한 단계 더 살펴보겠습니다.
직접 생각해 보기와 참고 자료
- 분기 자료에서 계절 AR(1)은 몇 시점 전의 값과 연결될까요?
- 예측 분산이 커지면 로그 정규 근사에서 평균과 중앙값의 차이는 어떻게 바뀔까요?
댓글남기기