상관계수가 같아도 산점도는 다르다
상관계수가 0.8인 두 자료는 같은 관계를 보일까요? 하나는 곡선이고 다른 하나는 특정 점 하나가 만든 직선 관계일 수도 있습니다. 숫자 하나는 편리하지만 모양까지 담지는 못하겠죠.
상관계수(correlation coefficient)가 무엇을 요약하는지 정의를 확인한 뒤, 같은 숫자가 다른 그림에서 어떻게 나타나는지 살펴보겠습니다.
상관계수 하나로 관계를 설명할 수 있을까요?
EDA에서는 두 수치형 변수의 관계를 산점도와 함께 확인하도록 권했습니다. Pearson 상관계수는 선형 관계를 요약하기 때문에 같은 계수라도 데이터의 모습은 매우 다를 수 있습니다.
R 기본 자료인 anscombe에는 이를 보여주는 네 쌍의 변수가 있습니다. 각 쌍은 11개 관측값으로 이루어져 있습니다.
data(anscombe)

summary_table <- do.call(rbind, lapply(1:4, function(i) {
  x <- anscombe[[paste0("x", i)]]
  y <- anscombe[[paste0("y", i)]]
  data.frame(set = i, mean_x = mean(x), mean_y = mean(y),
             sd_x = sd(x), sd_y = sd(y), pearson = cor(x, y))
}))
round(summary_table, 3)
네 쌍의 x 평균은 모두 9이고 y 평균은 약 7.5입니다. Pearson 상관계수도 약 0.816으로 거의 같습니다. 이제 그래프를 그려 봅니다.
old_par <- par(mfrow = c(2, 2), mar = c(4, 4, 2, 1))
for (i in 1:4) {
  x <- anscombe[[paste0("x", i)]]
  y <- anscombe[[paste0("y", i)]]
  plot(x, y, xlim = c(3, 20), ylim = c(2, 14),
       pch = 19, col = "#28765b", main = paste("Set", i))
  abline(lm(y ~ x), col = "#c87538", lwd = 2)
}
par(old_par)
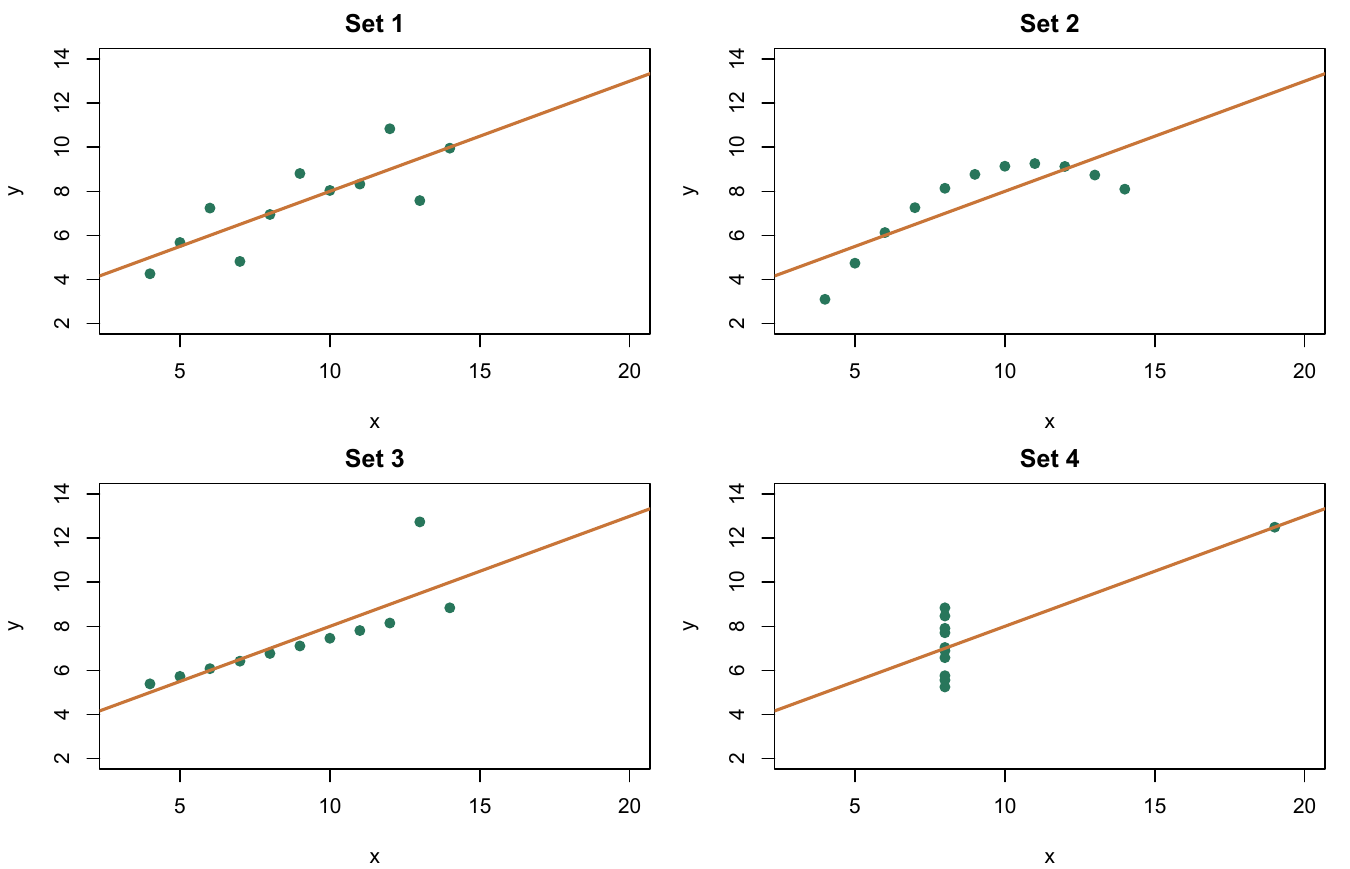
첫 번째는 대체로 직선 관계, 두 번째는 곡선 관계입니다. 세 번째는 한 점이 직선 적합에 큰 영향을 주며, 네 번째에서는 대부분의 x가 같고 오른쪽 한 점이 관계를 지배합니다. 숫자 요약만 보았다면 이 차이를 알기 어렵습니다.
Pearson과 Spearman은 어떤 관계를 묻나요?
Pearson 상관은 유한하고 양수인 두 분산을 이용해 공분산을 표준화한 값입니다.
\[\rho_{XY}=\frac{\operatorname{Cov}(X,Y)}{\sigma_X\sigma_Y}.\]단위를 없애 비교하기 편해지지만, 원래 공분산이 포착하는 선형 관계의 범위가 바뀌지는 않습니다. Spearman은 값을 순위로 바꿔 단조 관계를 살핀다는 점이 다릅니다.
| 계수 | 주로 요약하는 관계 | 주의할 점 |
|---|---|---|
| Pearson | 원래 값의 선형 관계 | 극단값에 민감하고 곡선 관계를 놓칠 수 있음 |
| Spearman | 순위의 단조 관계 | 모든 비선형 관계를 탐지하는 것은 아님 |
x <- seq(-3, 3, length.out = 61)
monotone_y <- x^3
curved_y <- x^2

c(pearson = cor(x, monotone_y),
  spearman = cor(x, monotone_y, method = "spearman"))
c(pearson = cor(x, curved_y),
  spearman = cor(x, curved_y, method = "spearman"))

plot(x, curved_y, pch = 19, col = "#28765b", xlab = "x", ylab = "x squared")
세제곱은 x가 증가할 때 y도 계속 증가하므로 Spearman 상관이 1입니다. 반면 제곱은 왼쪽에서 감소하고 오른쪽에서 증가합니다. 강한 관계가 있지만 Pearson과 Spearman 모두 이 대칭적인 U자 관계를 거의 0으로 요약합니다. 순위 상관도 산점도를 대신할 수 없습니다.
결측값이 있으면 비교 표본도 달라질까요?
d <- data.frame(
  x = c(1, 2, 3, 4, 5, NA),
  y = c(2, NA, 3, 5, 6, 8),
  z = c(3, 4, NA, 6, 7, 9)
)

cor(d, use = "complete.obs")
cor(d, use = "pairwise.complete.obs")
sapply(d, function(v) sum(!is.na(v)))
sum(complete.cases(d))
complete.obs는 여기서 세 변수 모두 관측된 행만 사용합니다. pairwise.complete.obs는 변수 쌍마다 이용 가능한 행을 사용하므로 계수마다 표본이 달라질 수 있습니다. 큰 상관행렬에서는 이 방법으로 얻은 행렬이 양의 준정부호가 아닐 수도 있어 후속 분석에 주의해야 합니다.
한 변수가 상수이면 표준편차가 0이므로 상관계수가 정의되지 않습니다. 이 경우 NA를 0으로 바꾸면 “관계가 없음”이라는 잘못된 의미를 부여하게 됩니다.
상관만으로 원인이라고 말할 수 있을까요?
기온이 높은 날에 아이스크림 판매와 물놀이 사고가 함께 증가할 수 있습니다. 이를 근거로 아이스크림 판매가 사고를 일으킨다고 결론 내리면 공통 원인인 기온 등을 놓칩니다. 반대 방향의 영향, 표본 선택, 시간 추세도 관계를 만들 수 있습니다.
집단을 합칠 때 관계가 달라지는 경우도 있습니다. 자동차의 배기량과 연비를 볼 때 차종별 산점도를 같이 확인해 보세요. 집단 안의 관계와 집단 간 차이는 같은 질문이 아닙니다. 인과효과를 추정하려면 연구 설계와 교란 요인에 대한 별도의 가정이 필요합니다.
무엇을 연결해서 기억하면 좋을까요?
관계의 방향과 모양을 먼저 확인하면 계수의 뜻도 더 정확히 읽을 수 있습니다. 이제 선형회귀에서 관계를 식으로 적고 잔차에 무엇이 남는지 알아보겠습니다.
직접 해볼까요?
anscombe의 세 번째 자료에서 가장 큰 y를 가진 점을 제외하고 상관계수를 비교하세요. 제거할 근거가 되는지와 숫자의 변화를 구분해 적으세요.ggplot2::mpg의displ과hwy산점도를 차종class별로 나누어 그려 보세요.cor.test()의 작은 p-value가 인과관계를 증명하지 못하는 이유를 설명하세요.
댓글남기기