교차검증과 데이터 누수: 성능이 지나치게 좋을 때
학습용과 검증용으로 나눴는데도 성능이 지나치게 좋다면 왜 그럴까요? 나누기 전에 전체 정답을 보고 변수를 골랐다면 검증 정보가 이미 모형에 들어간 셈이겠죠. 이를 데이터 누수(data leakage)라고 합니다.
모형 한 개뿐 아니라 전처리와 변수 선택까지 하나의 학습 절차로 생각하면, 교차검증(cross-validation)에서 무엇을 다시 계산해야 하는지 분명해집니다.
데이터를 나누었는데도 누수가 생기나요?
모델 평가 글에서는 학습·검증·테스트의 역할을 구분했습니다. 그런데 전체 자료에서 정답과 상관이 높은 변수를 먼저 고른 다음 교차검증을 하면, 검증 자료의 정답이 이미 변수 선택에 참여한 상태가 됩니다.
교차검증은 완성된 모형 하나를 나누어 평가하는 것이 아니라 새 자료를 받았을 때 수행할 학습 절차 전체를 평가해야 합니다.
진짜 신호가 없는 자료로 시작해 볼까요?
이번에는 모든 입력 변수와 정답을 서로 독립인 난수로 만듭니다. 따라서 새 관측값을 예측할 진짜 신호는 없습니다. 200개 변수 중 우연히 정답과 상관이 커 보이는 변수는 생길 수 있습니다.
set.seed(304)
n <- 100
p <- 200
x <- matrix(rnorm(n * p), nrow = n, ncol = p)
colnames(x) <- paste0("x", seq_len(p))
y <- rnorm(n)
fold <- sample(rep(1:5, length.out = n))

top_features <- function(rows, k = 5) {
  association <- abs(cor(x[rows, , drop = FALSE], y[rows]))
  order(as.vector(association), decreasing = TRUE)[seq_len(k)]
}

predict_fold <- function(train_rows, valid_rows, features) {
  training <- data.frame(y = y[train_rows], x[train_rows, features, drop = FALSE])
  validation <- data.frame(x[valid_rows, features, drop = FALSE])
  fit <- lm(y ~ ., data = training)
  as.numeric(predict(fit, newdata = validation))
}
변수 수를 늘릴수록 우연히 큰 표본 상관이 발견되기 쉽습니다. 이것이 모집단에 예측 신호가 있다는 뜻은 아닙니다.
변수 선택 순서를 바꾸면 성능도 달라질까요?
각 관측값은 자신이 속한 fold를 학습에 쓰지 않은 절차에서 예측을 받아야 합니다. 이렇게 얻은 예측을 ŷ_i^OOF라고 하면 전체 오차를 다음처럼 계산할 수 있습니다.
\[\mathrm{RMSE}_{OOF}=\sqrt{\frac1n\sum_{i=1}^{n}(y_i-\widehat y_i^{OOF})^2}.\]식 자체보다 중요한 것은 예측값이 만들어지는 과정입니다. 변수 선택에 해당 행의 정답을 사용했다면 모형 적합에서 행을 빼도 독립적인 검증이 되지 않습니다.
all_rows <- seq_len(n)
leaked_features <- top_features(all_rows)

pred_leaked <- pred_proper <- pred_baseline <- numeric(n)
for (k in 1:5) {
  train_rows <- which(fold != k)
  valid_rows <- which(fold == k)

  # 잘못된 예: 검증 정답까지 보고 고른 변수를 재사용합니다.
  pred_leaked[valid_rows] <- predict_fold(train_rows, valid_rows, leaked_features)

  # 올바른 예: 이번 fold의 학습 행만으로 변수를 다시 고릅니다.
  local_features <- top_features(train_rows)
  pred_proper[valid_rows] <- predict_fold(train_rows, valid_rows, local_features)
  pred_baseline[valid_rows] <- mean(y[train_rows])
}

rmse <- function(predicted) sqrt(mean((y - predicted)^2))
scores <- c(Baseline = rmse(pred_baseline),
            Leaked = rmse(pred_leaked), Proper = rmse(pred_proper))
round(scores, 3)

barplot(scores, col = c("#b9c7bf", "#d19368", "#44836a"),
        ylab = "Out-of-fold RMSE", ylim = c(0, max(scores) * 1.15))
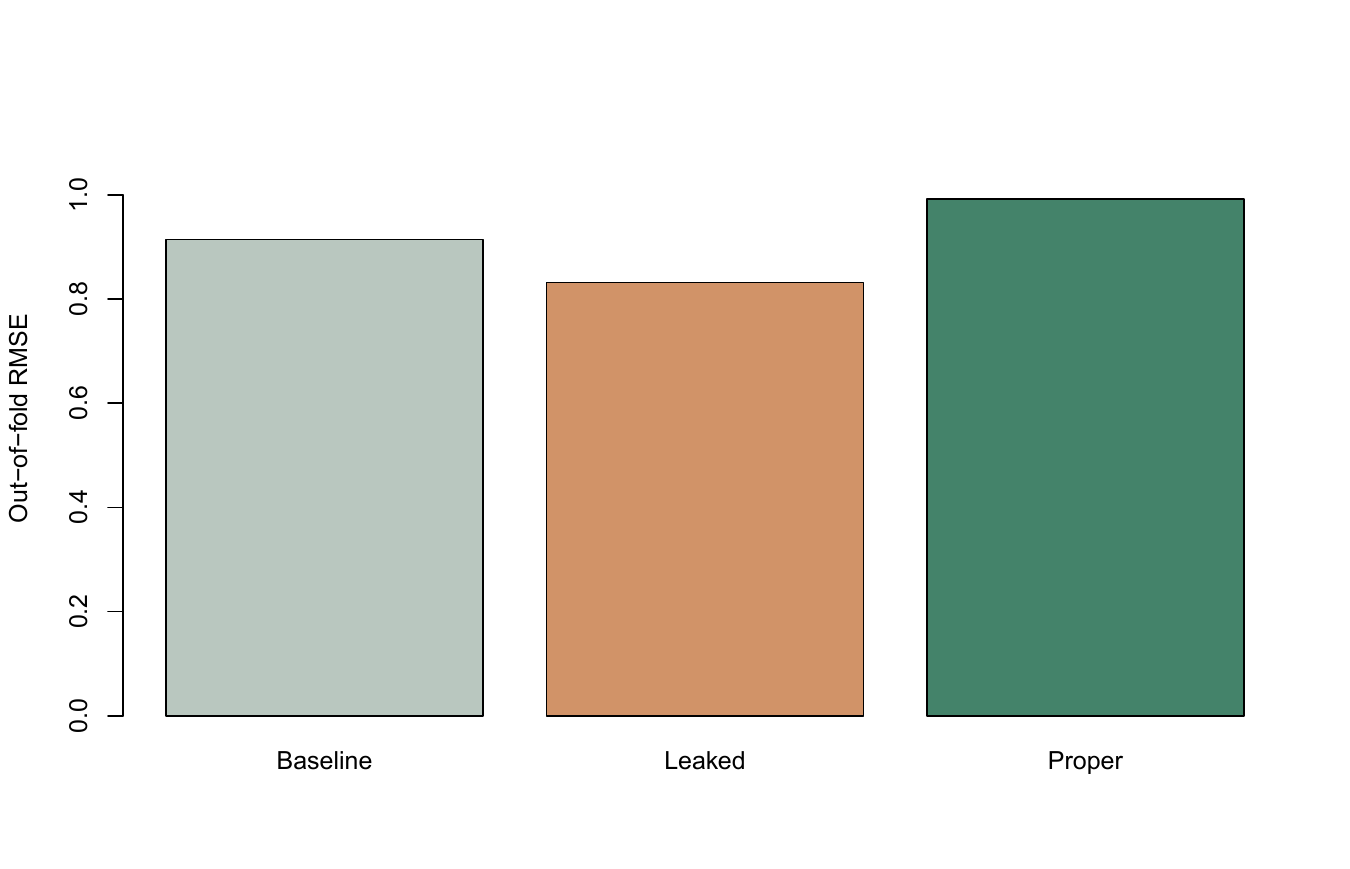
누수한 쪽의 점수가 더 좋아 보이더라도 이는 새 자료에 대한 예측력이 생겼다는 뜻이 아닙니다. 우연한 상관을 선택하는 과정에 검증 정답이 들어갔기 때문입니다. 제대로 평가한 모형은 기준 모형과 비슷하거나 더 나쁠 수 있습니다. 난수 실험이므로 한 번의 분할에서 반드시 특정한 순서가 나와야 하는 것은 아닙니다.
여기서 성능은 각 행이 자신을 학습에 쓰지 않은 모형에서 받은 예측값을 합쳐 계산했습니다. 이를 out-of-fold 예측이라고 합니다. fold별 오차를 평균하는 방식과 집계 방식이 다를 수 있으므로 어떤 정의를 썼는지 밝혀야 합니다.
대체와 표준화도 fold마다 다시 배워야 할까요?
다음 코드는 한 fold에서 쓸 전처리 방법입니다. 각 열의 중앙값·평균·표준편차는 학습 부분에서만 계산하고 검증 부분에 그대로 적용합니다.
fit_preprocessor <- function(training_x) {
  medians <- apply(training_x, 2, median, na.rm = TRUE)
  if (any(!is.finite(medians))) stop("A training column has no observed values")
  filled <- training_x
  for (j in seq_len(ncol(filled))) {
    filled[is.na(filled[, j]), j] <- medians[j]
  }
  centers <- colMeans(filled)
  scales <- apply(filled, 2, sd)
  scales[!is.finite(scales) | scales == 0] <- 1
  list(medians = medians, centers = centers, scales = scales)
}

apply_preprocessor <- function(new_x, prep) {
  filled <- new_x
  for (j in seq_len(ncol(filled))) {
    filled[is.na(filled[, j]), j] <- prep$medians[j]
  }
  sweep(sweep(filled, 2, prep$centers, "-"), 2, prep$scales, "/")
}

train_rows <- which(fold != 1)
valid_rows <- which(fold == 1)
prep <- fit_preprocessor(x[train_rows, , drop = FALSE])
scaled_train <- apply_preprocessor(x[train_rows, , drop = FALSE], prep)
scaled_valid <- apply_preprocessor(x[valid_rows, , drop = FALSE], prep)
round(colMeans(scaled_train)[1:3], 8)
같은 열 순서와 의미를 가진 수치형 행렬을 입력한다는 전제입니다. 여기서는 정규분포 난수여서 결측값은 없지만, 처리 위치를 보여주기 위해 함수를 나눴습니다. 전체가 결측인 열은 임의의 숫자로 채우지 않고 학습 규칙을 따로 정하도록 중단합니다.
학습 자료의 표준화 평균은 거의 0이 됩니다. 검증 자료의 평균까지 0일 필요는 없습니다. 검증 자료를 별도로 표준화하면 학습 기준과 다른 좌표가 됩니다.
어떤 단위로 나누어야 하나요?
| 실제 사용 상황 | 분할 원칙 | 흔한 누수 |
|---|---|---|
| 새 고객에게 예측 | 고객 ID를 기준으로 분리 | 같은 고객의 다른 행이 양쪽에 존재 |
| 미래 시점을 예측 | 과거로 학습하고 이후 구간에서 검증 | 미래 통계량·미래 결과를 입력으로 사용 |
| 새 병원·기관에 적용 | 기관 단위 분할 검토 | 기관 고유 패턴을 일반 성능으로 해석 |
| 과표집으로 희귀 클래스 학습 | fold 학습 부분에만 과표집 | 복제·합성 사례가 검증 쪽에 섞임 |
독립 관측값이라는 전제가 맞을 때 무작위 k-fold를 사용할 수 있습니다. 같은 사람의 반복 측정이나 시계열에 무작위 분할을 그대로 적용하면 실제 배포 상황보다 쉬운 문제를 평가할 수 있습니다.
여러 후보 중 고르면 검증 점수는 어떻게 읽을까요?
여러 모형·변수 수·전처리 방법 중 가장 좋은 교차검증 점수를 고르면 그 점수에도 선택의 낙관성이 생깁니다. 최종 테스트 자료를 남기거나, 외부 fold로 평가하고 내부 fold로 선택하는 nested cross-validation을 검토하세요.
이 예제는 누수 원리를 보여주기 위해 자료 전체에서 교차검증만 했습니다. 최종 제품 성능을 주장하는 실험이라면 개발 절차와 분리된 평가가 추가로 필요합니다. set.seed()는 재현성을 돕지만 분할의 타당성을 보장하지는 않습니다.
무엇을 연결해서 기억하면 좋을까요?
교차검증은 자료를 나누는 함수보다 정보가 흐르는 순서를 점검하는 방법입니다. 시간 순서가 있는 자료에서는 시계열 예측 검증처럼 미래를 볼 수 없는 상황도 반영해야 합니다.
직접 해볼까요?
- 입력 변수 수를 20과 1,000으로 바꿔 누수의 영향을 비교하세요.
- fold마다 선택된 변수 번호를 기록해 얼마나 자주 바뀌는지 확인해 보세요.
- 정답이 발생한 뒤에야 알 수 있는 변수가 입력 열에 있는 경우, 올바른 교차검증만으로 해결될까요?
댓글남기기