R로 PCA 실습하기: 표준화부터 주성분 해석까지
네 개의 수치형 변수를 두 축에 그리면서 중요한 차이를 남길 수 있을까요? 서로 함께 변하는 방향을 찾으면 자료를 더 간단하게 볼 수 있겠죠. 주성분 분석(principal component analysis, PCA)은 이런 새 좌표를 만드는 방법입니다.
축이 만들어지는 기준을 이해한 뒤 설명 분산, loading, score를 차례로 연결하겠습니다. 그림에서 잘 나뉜다는 사실과 예측 성능이 좋다는 사실도 구분해 보겠습니다.
네 변수를 두 축으로 줄여 볼까요?
데이터 축소 개요에서는 PCA가 기존 변수의 선형결합으로 주성분을 만든다고 설명했습니다. 이번에는 R의 prcomp()로 직접 계산합니다.
iris에는 꽃 150개의 꽃받침·꽃잎 길이와 너비, 품종이 들어 있습니다. 네 수치형 변수만 PCA에 사용하고 품종은 나중에 그림의 색으로 표시합니다. 품종은 PCA의 입력이 아닙니다.
data(iris)
set.seed(318)
train_id <- unlist(lapply(split(seq_len(nrow(iris)), iris$Species), function(ids) {
  sample(ids, 40)
}), use.names = FALSE)

train_x <- iris[train_id, 1:4]
test_x <- iris[-train_id, 1:4]
train_species <- iris$Species[train_id]
test_species <- iris$Species[-train_id]
stopifnot(nrow(train_x) == 120, nrow(test_x) == 30)

pca_raw <- prcomp(train_x, center = TRUE, scale. = FALSE)
pca_scaled <- prcomp(train_x, center = TRUE, scale. = TRUE)
품종별로 40개를 학습에 사용했습니다. 이는 예제의 시각적 비교를 위한 층화 분할이며, PCA를 맞출 때 정답을 사용하는 것은 아닙니다. 실제 적용에서는 미래 관측값이 어떻게 들어오는지에 맞게 분할해야 합니다.
표준화하면 무엇이 달라지나요?
apply(train_x, 2, sd)

explained <- function(fit) {
  variance <- fit$sdev^2
  variance / sum(variance)
}
round(rbind(Unscaled = explained(pca_raw),
            Scaled = explained(pca_scaled)), 3)
네 변수는 모두 cm 단위이지만 변동 폭은 다릅니다. 표준화하지 않으면 분산이 큰 변수가 축을 더 많이 좌우할 수 있습니다. 표준화하면 학습 표본에서 각 변수의 분산을 1로 맞추어 상대적인 변화를 비교합니다.
단위가 같다고 표준화가 불필요한 것도, 단위가 다르다고 언제나 표준화가 정답인 것도 아닙니다. 원래 분산의 차이가 의미 있는 신호인지, 측정 단위 때문에 생긴 차이인지 분석 목적에 따라 판단하세요. 분산이 0인 열은 표준화할 수 없고, 결측값도 먼저 정한 규칙으로 처리해야 합니다.
주성분은 몇 개를 남기면 좋을까요?
각 주성분의 분산을 λ_j라고 할 때 설명 비율은 다음과 같습니다.
\[\text{PC}_j\text{의 설명 비율}=\frac{\lambda_j}{\sum_{k=1}^{p}\lambda_k}.\]분모는 PCA에 사용한 척도에서의 전체 분산입니다. 표준화 여부가 달라지면 기준 척도도 달라집니다. 이 비율을 예측 정답의 설명 비율로 바꾸어 읽지 않도록 주의하세요.
ratio <- explained(pca_scaled)
variance_table <- data.frame(
  component = paste0("PC", seq_along(ratio)),
  proportion = ratio,
  cumulative = cumsum(ratio)
)
variance_table

barplot(ratio, names.arg = variance_table$component,
        col = "#6eaa8e", ylab = "Proportion of variance explained",
        ylim = c(0, 1))
abline(h = 0.1, col = "gray70", lty = 2)
처음 두 축에서 대부분의 분산을 설명하는지 누적 비율로 확인할 수 있습니다. 80%나 90%는 흔히 쓰는 기준일 뿐 보편적인 정답은 아닙니다. 그림을 그리려면 두 축이 편리하지만 예측이 목적이라면 주성분 수를 학습 자료 안의 검증으로 정해야 합니다.
분산이 크다는 이유만으로 결과 변수를 잘 예측하는 정보라고 볼 수 없습니다. 작은 분산 방향에 중요한 예측 신호가 있을 수도 있습니다.
Loading과 score는 어떻게 다를까요?
round(pca_scaled$rotation[, 1:2], 3)
head(pca_scaled$x[, 1:2])

colors <- c("#32745b", "#c0793c", "#666da1")
plot(pca_scaled$x[, 1], pca_scaled$x[, 2],
     pch = 19, col = colors[as.integer(train_species)],
     xlab = paste0("PC1 (", round(100 * ratio[1], 1), "%)"),
     ylab = paste0("PC2 (", round(100 * ratio[2], 1), "%)"))
legend("topright", legend = levels(train_species), col = colors, pch = 19)
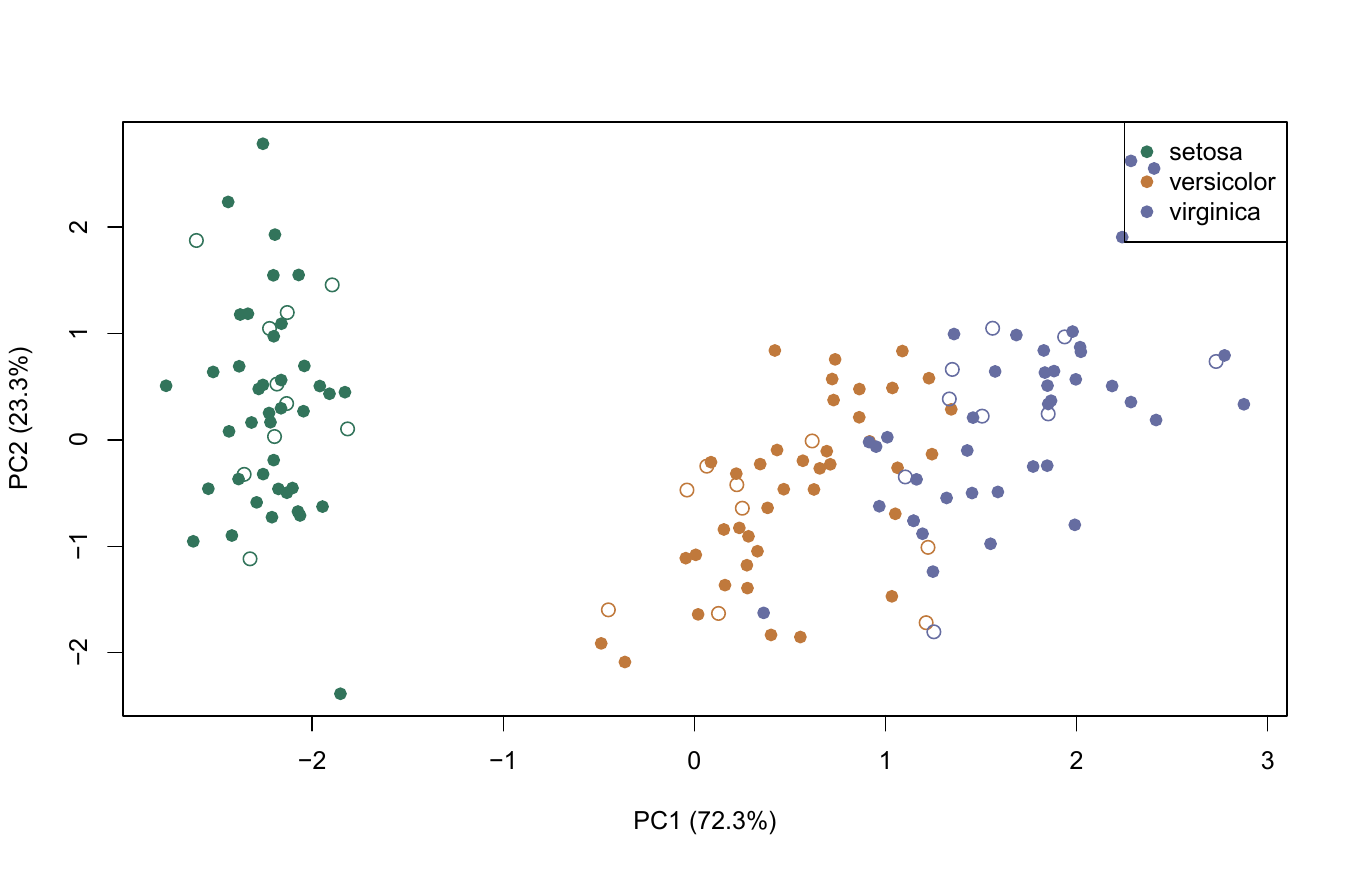
그림의 채운 점은 학습 자료이고, 빈 원은 아래의 predict() 단계에서 같은 축에 투영한 테스트 자료입니다.
rotation은 새 축을 만드는 계수, 즉 loading입니다. 각 변수가 어떤 조합으로 축에 기여하는지 봅니다. x는 학습 관측값을 그 축에 투영한 score입니다. 계수의 부호·상대 크기를 함께 읽되, loading만 보고 인과관계를 해석하면 안 됩니다.
주성분 축의 부호는 전체를 뒤집어도 같은 해입니다. 실행 환경에 따라 PC1이 좌우 반전되어도 거리와 설명 분산이 유지된다면 모순이 아닙니다. 학습 자료에서 주성분 점수들은 서로 무상관이지만 통계적 독립을 보장하지는 않습니다.
새 자료는 어떤 축으로 옮겨야 할까요?
test_scores <- predict(pca_scaled, newdata = test_x)

manual_scores <- scale(test_x,
                       center = pca_scaled$center,
                       scale = pca_scaled$scale) %*% pca_scaled$rotation
stopifnot(isTRUE(all.equal(unname(test_scores), unname(manual_scores))))

points(test_scores[, 1], test_scores[, 2],
       pch = 1, col = colors[as.integer(test_species)], cex = 1.2)
predict()가 학습 평균·척도·축을 재사용합니다. 테스트 자료에 prcomp()를 다시 적합하면 다른 좌표계가 만들어지므로 같은 모형의 입력으로 사용할 수 없습니다. 테스트 자료의 score가 평균 0이어야 할 이유도 없습니다.
그림의 품종별 분리는 표본과 선택한 변수에 관한 관찰입니다. 이것만으로 새 꽃을 얼마나 정확히 분류하는지 증명되지는 않습니다. 분류 모형을 추가한다면 전처리와 PCA를 각 교차검증 fold 안에서 적합해야 합니다.
두 축만 남기면 어떤 정보를 잃을까요?
k <- 2
train_z <- scale(train_x, center = pca_scaled$center, scale = pca_scaled$scale)
reconstructed_z <- pca_scaled$x[, 1:k, drop = FALSE] %*%
                   t(pca_scaled$rotation[, 1:k, drop = FALSE])
mean((train_z - reconstructed_z)^2)

reconstructed <- sweep(reconstructed_z, 2, pca_scaled$scale, "*")
reconstructed <- sweep(reconstructed, 2, pca_scaled$center, "+")
head(reconstructed)
앞의 오차는 표준화된 척도에서 계산했습니다. 원래 단위의 복원값을 보고 변수가 어떤 정보를 잃었는지도 확인할 수 있습니다. 학습 복원 오차가 작다는 것과 테스트 예측 성능이 좋다는 것은 다른 평가입니다.
무엇을 연결해서 기억하면 좋을까요?
PCA는 자료의 분산을 보존하는 새 좌표를 만드는 방법입니다. 좌표를 학습한 범위를 지키려면 전처리와 데이터 누수도 함께 확인해 보겠습니다.
직접 해볼까요?
- 같은 학습 자료에서 표준화 유무에 따른 첫 번째 주성분의 loading을 비교하세요.
k를 1부터 4까지 바꾸며 복원 오차를 계산하세요. 4개를 모두 남기면 어떤 결과가 나와야 하나요?- 테스트 자료에 PCA를 다시 적합하면 문제가 되는 이유를 좌표계의 관점에서 설명하세요.
댓글남기기