p-value 다음에 읽는 신뢰구간과 효과 크기
두 연구에서 같은 2점 차이를 관측했는데 p-value가 다를 수 있을까요? 표본 수와 변동이 다르면 추정의 정밀도도 달라지겠죠. 차이의 크기와 그 차이를 얼마나 정확히 추정했는지는 따로 읽어야 합니다.
효과 크기(effect size)는 차이를, 신뢰구간(confidence interval)은 추정 절차의 불확실성을 보여줍니다. 두 도구를 p-value와 연결해 보겠습니다.
유의하다는 말 다음에는 무엇이 필요한가요?
p-value 글에서는 작은 p-value가 큰 효과를 뜻하지 않는다고 설명했습니다. 평균 차이가 2점인 시험 결과도 표본이 많고 변동이 작으면 작은 p-value를 만들 수 있습니다. 반대로 중요한 차이가 있어도 표본이 적으면 불확실성이 클 수 있습니다.
독자가 알고 싶은 것은 “차이가 있는가?”에 더해 “얼마나 차이가 나며, 어느 정도까지 확신할 수 있는가?”입니다. 이를 위해 효과 크기와 신뢰구간을 함께 제시합니다.
평균 차이의 신뢰구간은 어떻게 계산할까요?
두 독립 집단이 같은 분산을 갖는다고 가정한 pooled t 구간에서는 평균 차이 주변에 다음 폭을 더하고 뺍니다.
\[(\bar x_B-\bar x_A)\ \pm\ t_{0.975,\,n_A+n_B-2}\, s_p\sqrt{\frac{1}{n_A}+\frac{1}{n_B}}.\]s_p는 두 집단의 pooled 표준편차입니다. 표본 수가 커지면 평균 차이의 표준오차가 줄어드는 구조가 보이죠. 분산이 다르다면 Welch 방법처럼 그에 맞는 표준오차와 자유도를 사용합니다.
두 독립 집단에서 각각 25명을 관측했다고 합시다. A의 평균은 70점, B는 72점이고 두 집단의 표준편차는 모두 10점입니다. 아래 코드는 요약 통계량으로 계산한 가상 예제입니다.
compare_means <- function(n) {
  difference <- 72 - 70
  pooled_sd <- 10
  standard_error <- pooled_sd * sqrt(2 / n)
  df <- 2 * n - 2
  margin <- qt(0.975, df = df) * standard_error
  data.frame(
    n_per_group = n,
    difference = difference,
    low = difference - margin,
    high = difference + margin,
    p_value = 2 * pt(-abs(difference / standard_error), df = df),
    cohens_d = difference / pooled_sd
  )
}

results <- do.call(rbind, lapply(c(25, 250, 2500), compare_means))
print(results, digits = 4)
| 집단별 표본 수 | 평균 차이 | 95% 신뢰구간, 약 | p-value, 약 | Cohen’s d |
|---|---|---|---|---|
| 25 | 2점 | -3.69 ~ 7.69 | 0.483 | 0.2 |
| 250 | 2점 | 0.24 ~ 3.76 | 0.026 | 0.2 |
| 2500 | 2점 | 1.45 ~ 2.55 | 0.000000000002 | 0.2 |
이 비교는 평균과 표준편차를 고정하고 표본 수만 바꾼 것입니다. 실제 표집에서는 평균과 표준편차도 매번 달라집니다. 두 집단의 분산이 같고 관측이 독립이라는 가정 아래 pooled t 방법을 사용했습니다. 일반적인 실제 분석에서는 Welch t-test도 검토하세요.
plot(results$difference, 1:3, xlim = range(results$low, results$high),
     yaxt = "n", xlab = "Mean difference (B - A)", ylab = "",
     pch = 19, col = "#28765b")
axis(2, at = 1:3, labels = paste("n =", results$n_per_group), las = 1)
segments(results$low, 1:3, results$high, 1:3, lwd = 2)
abline(v = 0, lty = 2, col = "gray50")
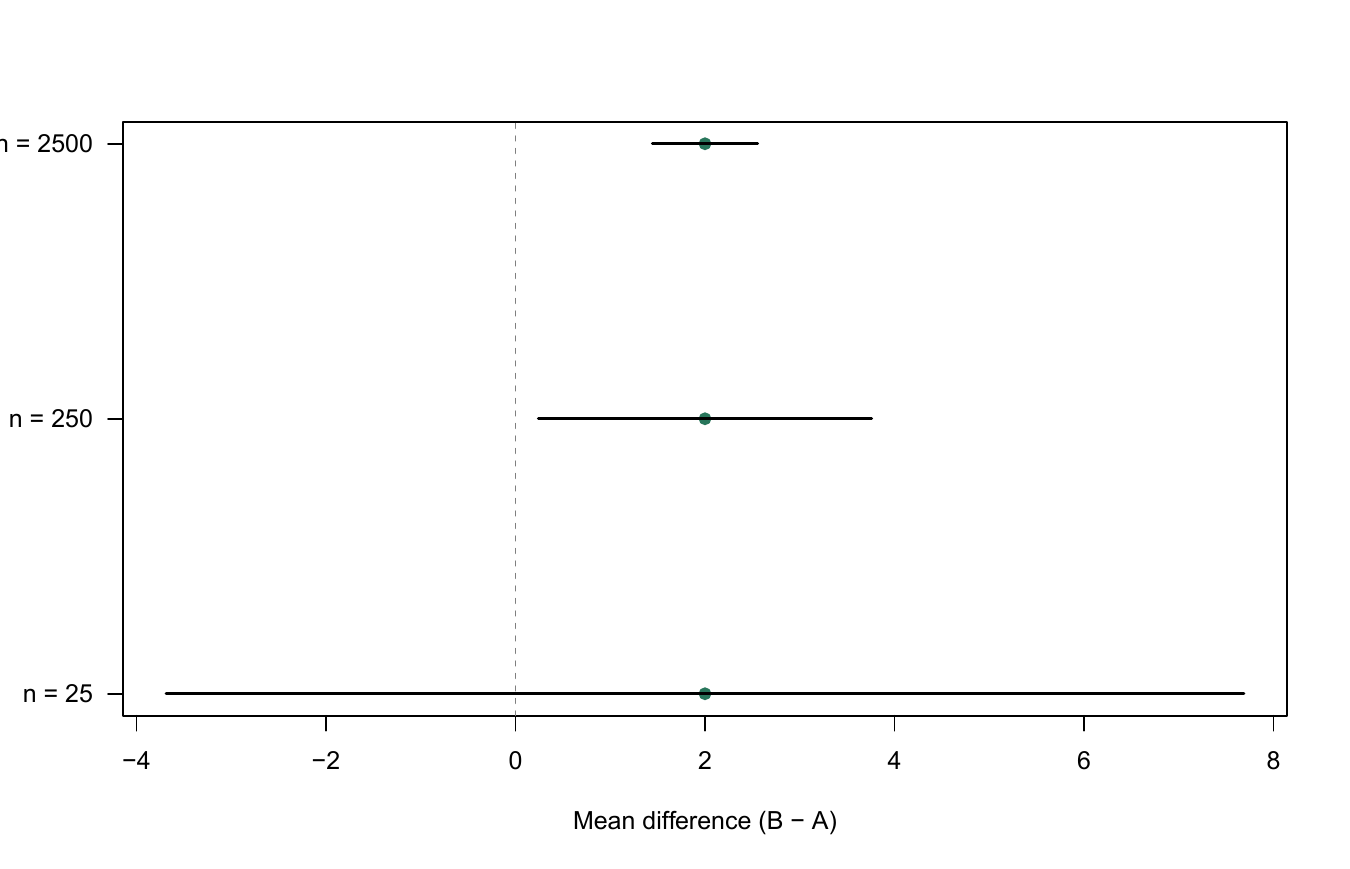
차이는 같은 2점이고 Cohen’s d도 같습니다. 표본 수가 늘면서 표준오차와 신뢰구간의 폭이 줄고 p-value가 작아집니다. 통계적 유의성이 달라져도 2점의 실무적 가치는 별도로 판단해야 합니다.
95% 신뢰구간을 어떻게 읽나요?
빈도주의 신뢰구간의 95%는 같은 절차로 표본을 반복해서 뽑아 구간을 만들면, 그 구간들 중 약 95%가 고정된 모집단 값을 포함한다는 뜻입니다. 이미 계산한 특정 구간에 참값이 들어갈 확률이 95%라고 해석하는 것은 이 정의와 다릅니다.
다음 실험은 평균이 0인 모집단에서 20개씩 뽑아 신뢰구간을 1,000번 계산합니다.
set.seed(114)
covered <- replicate(1000, {
  x <- rnorm(20, mean = 0, sd = 1)
  interval <- t.test(x)$conf.int
  interval[1] <= 0 && interval[2] >= 0
})
mean(covered)
비율은 0.95 근처가 되겠지만 정확히 0.95일 필요는 없습니다. 이것도 유한한 반복 실험이기 때문입니다. 표본의 독립성이나 모형 가정이 크게 어긋나면 명목상 95%라는 숫자만으로 실제 포함률을 보장할 수 없습니다.
효과 크기는 어떤 것을 쓰나요?
| 지표 | 답하는 질문 | 해석 시 주의점 |
|---|---|---|
| 평균 차이 | 원래 단위로 얼마나 다른가? | 점수·시간·금액 등 단위를 적습니다. |
| Cohen’s d | 집단 차이가 표준편차의 몇 배인가? | 표준화 기준과 분산 가정을 확인합니다. |
| 위험 차이 | 사건 발생 비율이 몇 %p 다른가? | 비율 변화와 상대 변화는 다릅니다. |
| 위험비 | 한 집단의 위험이 다른 집단의 몇 배인가? | 기준 위험도 함께 보고합니다. |
예를 들어 발생률이 2%에서 1%가 되면 위험비는 0.5이지만 절대 차이는 -1%p입니다. 두 수치는 서로 다른 질문에 답하므로 함께 제시하면 유용합니다. d가 0.2라는 이유로 모든 분야에서 중요하지 않다고 결론 내릴 수도 없습니다.
결과를 한 문장으로 어떻게 보고할까요?
“유의한 차이를 발견했다”보다 “B의 평균이 A보다 2점 높았고, 평균 차이의 95% 신뢰구간은 0.24~3.76점이었다. 집단별 표본은 250명이며, 사전에 중요하다고 정한 차이는 5점이었다”가 더 많은 정보를 줍니다.
신뢰구간이 0을 포함하면 차이가 없다고 증명된 것은 아닙니다. 동등성을 보이려면 사전에 허용할 차이를 정하고 동등성 검정이나 그에 맞는 구간 해석을 사용해야 합니다. 신뢰구간이 좁아도 표본 선택 편향이나 측정 오류가 해결되는 것은 아닙니다.
무엇을 연결해서 기억하면 좋을까요?
구간이 좁다는 사실과 효과가 크다는 사실은 다릅니다. 이제 실제 자료의 설계에 맞춰 두 집단 비교를 하면서 차이와 구간을 함께 보고해 보겠습니다.
직접 해볼까요?
compare_means()의 평균 차이를 5점으로 바꾸고 표를 다시 만드세요.- 표본 수를 고정하고 표준편차를 5와 20으로 바꾸면 구간 폭이 어떻게 달라지나요?
- 본인 분야에서 의미 있는 최소 차이를 원래 단위로 적어 보세요.
댓글남기기