이상치는 언제 제거해야 할까?
다른 값보다 유난히 큰 관측값을 발견하면 지워도 될까요? 입력 오류일 수도 있지만 실제로 중요한 드문 사례일 수도 있겠죠. 이상치(outlier)를 찾는 것과 제거할 근거를 마련하는 것은 다른 단계입니다.
탐지 기준의 뜻을 이해한 뒤 원자료를 확인하고, 포함·제외 결과를 비교하는 순서로 살펴보겠습니다.
상자그림 밖의 점은 틀린 값인가요?
바이올린 플롯과 상자그림에서 수염 밖에 있는 점은 이상치 후보입니다. 키가 700cm라면 단위나 입력 오류를 의심할 수 있지만, 매출이 다른 고객보다 훨씬 큰 기업 고객은 유효한 관측값일 수 있습니다.
후자를 단지 평균을 많이 바꾼다는 이유로 지우면 중요한 현상을 제거할 수 있습니다. 특히 사기·고장 탐지에서는 드문 사례 자체가 분석의 목적입니다.
IQR은 어떤 값을 후보로 표시할까요?
사분위수 Q₁·Q₃ 사이의 폭을 사분위 범위(interquartile range, IQR)라고 합니다. 흔히 쓰는 탐색 경계는 다음과 같습니다.
\[IQR=Q_3-Q_1,\qquad [Q_1-1.5IQR,\ Q_3+1.5IQR].\]경계 밖이라는 사실은 가운데 자료에서 멀리 떨어져 있다는 단서입니다. 오류일 확률을 계산한 것이 아니므로 자료의 맥락을 이어 확인해야 합니다.
가상 대기시간 자료를 사용하겠습니다. 단위는 분입니다.
waiting <- data.frame(
  id = 1:10,
  minutes = c(10, 11, 12, 12, 13, 14, 15, 16, 17, 70)
)

q <- quantile(waiting$minutes, probs = c(0.25, 0.75), type = 7)
iqr <- q[2] - q[1]
lower <- q[1] - 1.5 * iqr
upper <- q[2] + 1.5 * iqr

waiting$flag <- waiting$minutes < lower | waiting$minutes > upper
waiting
c(lower = unname(lower), upper = unname(upper))
이 자료의 경계는 약 6.38분과 21.38분이며 70분인 관측값이 표시됩니다. 1.5×IQR은 흔히 쓰는 탐색 기준이지 오류 판정의 확률 기준은 아닙니다. 자료가 많거나 분포가 치우치면 유효한 값도 여러 개 표시될 수 있습니다.
R의 boxplot()은 일부 표본 크기에서 quantile(type = 7)과 다른 사분위수 계산인 hinges를 사용합니다. 따라서 직접 계산한 경계와 그림의 수염이 언제나 정확히 같다고 가정하면 안 됩니다.
그림 밖의 원자료에서도 확인해 볼까요?
boxplot(waiting$minutes, horizontal = TRUE, outline = FALSE,
        ylim = range(waiting$minutes),
        xlab = "Waiting time (minutes)", col = "#d5e6dc")
stripchart(waiting$minutes, method = "stack", add = TRUE,
           pch = 19, col = "#28765b")
points(waiting$minutes[waiting$flag], rep(1, sum(waiting$flag)),
       pch = 19, col = "#b45232")
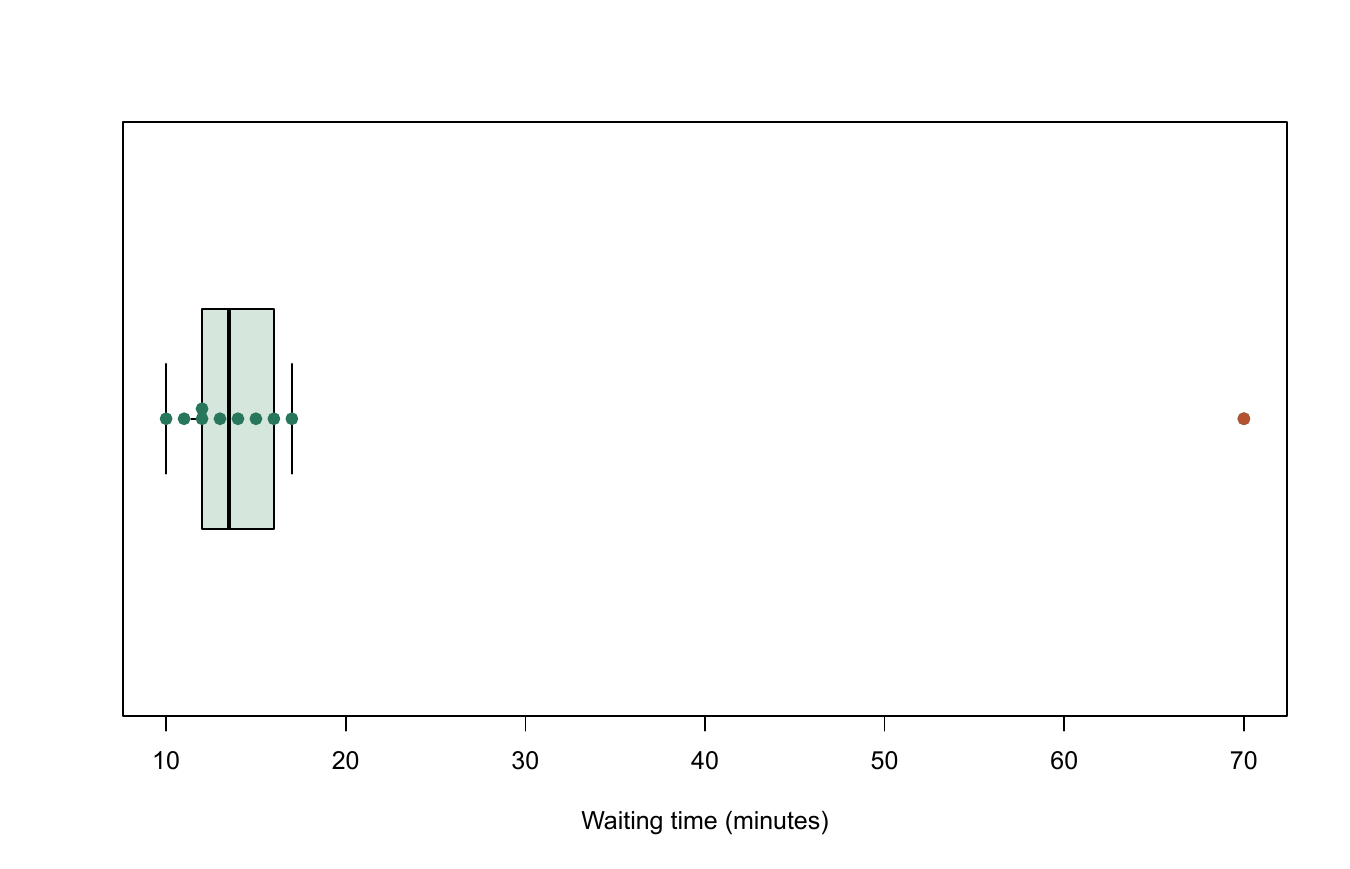
70분을 확인할 때는 “다른 값보다 큰가?”에 이어 다음을 살핍니다.
- 원 기록도 70분인가요, 아니면 7.0을 잘못 옮겼나요?
- 이 사례만 초 단위로 기록된 것은 아닌가요?
- 장비 중단, 재방문 등 다른 측정 과정이 있었나요?
- 분석 대상에 포함되는 정상적인 장시간 대기인가요?
오류가 확인되면 근거를 남기고 수정합니다. 확인되지 않은 값을 추측해서 7로 고쳐서는 안 됩니다.
제거 전후 결론은 얼마나 달라질까요?
summarise_wait <- function(x) {
  c(n = length(x), mean = mean(x), median = median(x),
    sd = sd(x), trimmed_mean = mean(x, trim = 0.1))
}

comparison <- rbind(
  all = summarise_wait(waiting$minutes),
  without_flagged = summarise_wait(waiting$minutes[!waiting$flag])
)
round(comparison, 2)
전체 평균은 19분이고 70분을 제외하면 약 13.33분입니다. 전체 중앙값은 13.5분으로 극단값의 영향이 평균보다 작습니다. 이처럼 결론이 처리 방법에 따라 달라진다면 그 사실을 보고해야 합니다.
절사평균은 양끝의 일정 비율을 제외합니다. trim = 0.1은 큰 값만 골라 지우는 방법이 아닙니다. 또한 “평균 대기시간”과 “중앙 대기시간”은 서로 다른 모집단 특성을 추정하므로 강건하다는 이유만으로 바꾸어 보고하면 안 됩니다.
분석 목적에 따라 처리가 달라질까요?
| 상황 | 고려할 처리 | 함께 남길 정보 |
|---|---|---|
| 입력 오류가 원자료로 확인됨 | 원래 값으로 수정 | 수정 근거와 이력 |
| 측정 실패로 사용 불가능 | 결측 처리 또는 사전 기준에 따른 제외 | 누락 수와 실패 원인 |
| 유효한 긴 꼬리 자료 | 원자료 유지, 로그 척도·강건한 방법 검토 | 원래 단위 해석과 분포 |
| 대상 모집단 밖의 사례 | 사전에 정한 포함 기준 적용 | 기준과 제외 사례 수 |
로그 변환은 큰 값을 압축하지만 0과 음수에는 그대로 적용할 수 없습니다. 임의로 1을 더하면 변수의 단위에 따라 의미가 달라질 수 있습니다. 윈저화는 경계 밖 값을 경계로 바꾸는 방법으로, 분산과 관계를 바꾸므로 기준과 민감도 분석이 필요합니다.
회귀분석에서는 y가 극단적이지 않아도 x가 독특한 점이 큰 영향력을 가질 수 있습니다. 잔차, leverage, Cook’s distance를 함께 보는 이유는 선형회귀 글에서 다룹니다.
예측 모델의 이상치 경계나 변환 기준은 학습 데이터에서 정해야 합니다. 테스트 데이터까지 보고 경계를 고르면 성능 평가에 정보가 섞입니다.
무엇을 연결해서 기억하면 좋을까요?
이상치의 처리는 원하는 결과가 아니라 관측의 타당성과 분석 목적에 근거해야 합니다. 다음에는 회귀 진단에서 독특한 x값과 큰 잔차의 영향도 구분해 보겠습니다.
직접 해볼까요?
- 70을 7로 바꾼 자료와 70을 유지한 자료의 평균·중앙값을 비교하세요. 두 경우가 각각 어떤 가정을 하는지 적으세요.
- 70이 실제 긴급 장애로 확인되었다면 일반 대기시간 분석과 장애 탐지 분석에서 처리가 같아야 할까요?
- 제거 전후 수치가 비슷하더라도 제외 기준을 기록해야 하는 이유를 설명하세요.
댓글남기기