R로 두 집단 비교하기: 독립표본·대응표본과 Welch t-test
두 숫자 열이 있으면 곧바로 t-test를 실행하면 될까요? 서로 다른 사람의 점수인지, 같은 사람의 전후 점수인지에 따라 비교 방법이 달라지겠죠. 검정(test)은 표 모양보다 자료가 만들어진 방식을 먼저 보아야 합니다.
독립 집단에서는 Welch 방법을, 연결된 관측에서는 쌍 안의 차이를 생각하며 평균 차이와 신뢰구간까지 함께 읽어 보겠습니다.
어떤 두 집단을 비교하나요?
두 학급의 평균 점수를 비교하는 경우와 같은 학생들의 교육 전후 점수를 비교하는 경우를 생각해 봅시다. 두 경우 모두 숫자 열 두 개를 만들 수 있지만, 두 번째에는 같은 학생이라는 연결이 있습니다.
| 자료의 구조 | 비교 대상 | 출발점 |
|---|---|---|
| 서로 다른 사람으로 이루어진 두 집단 | 두 모집단의 평균 차이 | 독립표본 Welch t-test |
| 같은 사람의 전후 또는 의미 있게 짝지은 자료 | 쌍 안의 차이의 평균 | 대응표본 t-test |
| 학교·병원 등 군집 안에 사람이 속함 | 군집 의존성을 고려한 차이 | 군집 구조에 맞는 모형 검토 |
독립성은 정규성 검정으로 확인할 수 없습니다. 배정 방식과 표집 단위 같은 연구 설계의 정보가 필요합니다. 평균 차이가 인과효과인지도 검정 함수가 결정해 주지 않습니다.
독립된 두 집단은 Welch 방법으로 어떻게 비교할까요?
Welch 검정은 두 집단의 표본 분산을 각각 사용해 평균 차이의 표준오차를 계산합니다. 평균 차이가 0이라는 귀무가설에서는 다음 통계량을 사용합니다.
\[t=\frac{\bar x_B-\bar x_A}{\sqrt{s_B^2/n_B+s_A^2/n_A}}.\]표본 수와 분산이 표준오차에 함께 들어갑니다. 독립성·표집 조건을 확인하고 Welch 근사 자유도로 구간과 p-value를 계산합니다. 같은 사람의 짝 자료라면 이 독립표본 식을 그대로 사용하지 않습니다.
서로 다른 사람으로 구성된 대조군과 처리군의 가상 점수입니다. 패키지 설치 없이 실행할 수 있습니다.
control <- c(50, 52, 53, 55, 56, 58, 60, 61)
treated <- c(54, 55, 57, 60, 63, 65, 66, 68)

data.frame(
  group = c("Control", "Treated"),
  n = c(length(control), length(treated)),
  mean = c(mean(control), mean(treated)),
  sd = c(sd(control), sd(treated))
)

welch <- t.test(treated, control, alternative = "two.sided", var.equal = FALSE)
welch
c(difference = mean(treated) - mean(control),
  low = welch$conf.int[1], high = welch$conf.int[2], p = welch$p.value)
첫 번째 인자에 처리군을 넣었으므로 차이의 방향은 ‘처리군 − 대조군’입니다. 신뢰구간이나 결론을 적기 전에 이 방향을 확인해 보세요.
Welch t-test는 두 집단의 분산이 같다고 가정하지 않습니다. t.test()의 독립 두 표본 기본값도 Welch 방법입니다. 등분산 검정에서 유의하지 않았다는 이유만으로 등분산이 확인되었다고 보기는 어렵습니다. Welch를 일관된 출발점으로 삼고, 설계나 모형에 특별한 이유가 있을 때 다른 방법을 검토할 수 있습니다.
boxplot(control, treated, names = c("Control", "Treated"),
        ylab = "Score", col = c("#d5e6dc", "#ecd4b2"))
stripchart(list(control, treated), vertical = TRUE, method = "stack",
           add = TRUE, pch = 19, col = "#3a6857")
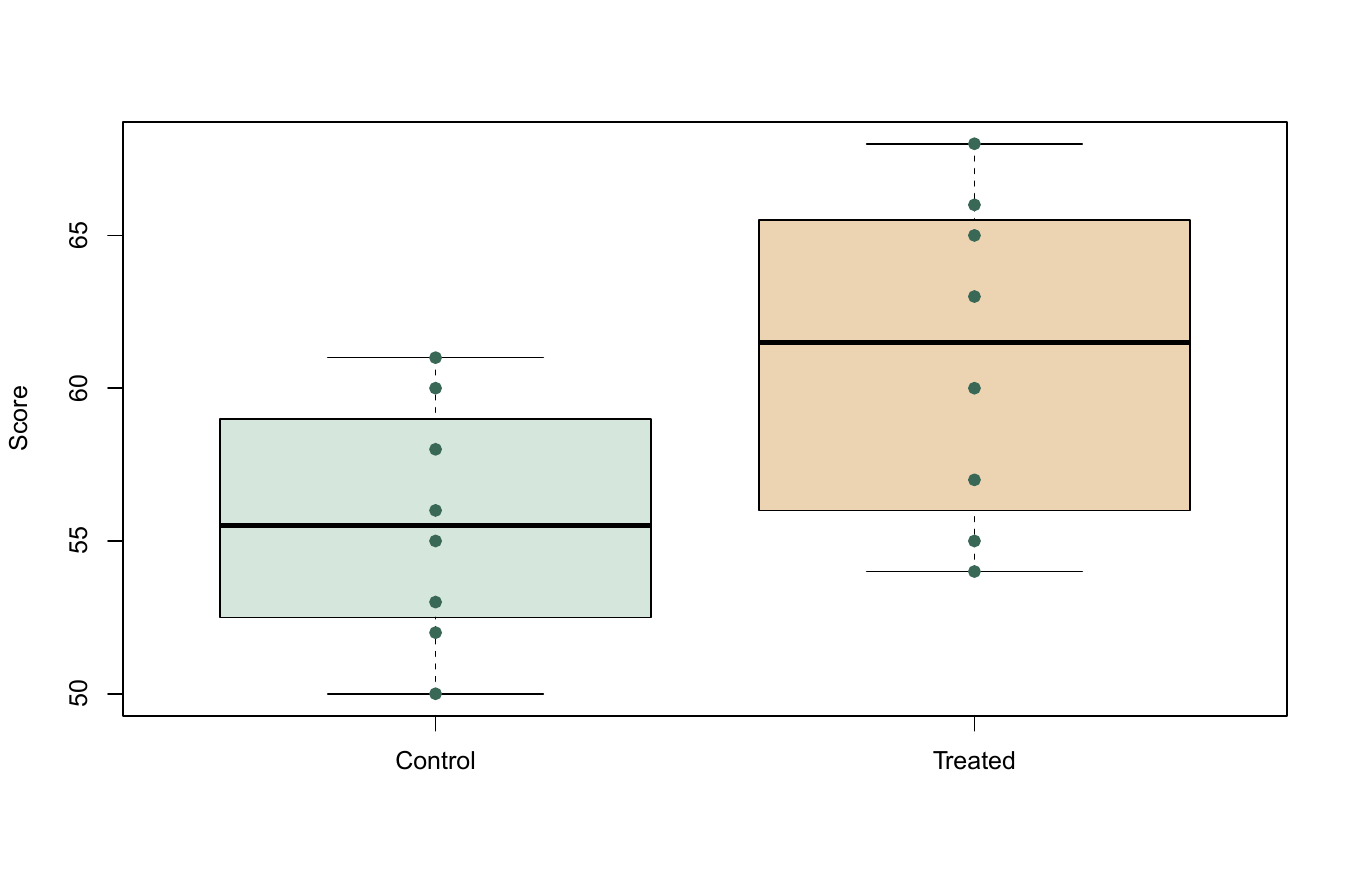
표본이 작으므로 평균·표준편차와 개별 관측값을 함께 확인합니다. 큰 이상치나 심한 비대칭이 있는지 살피되, p-value가 작아지도록 관측값을 골라 제거해서는 안 됩니다.
같은 사람의 전후 자료는 어떻게 비교할까요?
R의 sleep 자료는 같은 10명에 대해 두 약물 조건의 추가 수면 시간을 기록했습니다. 쌍을 눈으로 추정해 맞추기보다 ID로 연결합니다.
data(sleep)
wide <- reshape(sleep, idvar = "ID", timevar = "group", direction = "wide")
wide <- wide[order(wide$ID), ]
stopifnot(!anyDuplicated(wide$ID), nrow(wide) == 10)

paired <- t.test(wide$extra.2, wide$extra.1, paired = TRUE)
paired
difference <- wide$extra.2 - wide$extra.1
c(mean_difference = mean(difference), sd_difference = sd(difference))

qqnorm(difference)
qqline(difference)
조건 2에서 조건 1을 뺀 평균 차이는 약 1.58시간이고, 95% 신뢰구간은 약 0.70~2.46시간입니다. 대응표본 t-test는 각 쌍의 차이에 대한 일표본 t-test와 같습니다. 검토할 분포는 각 조건의 주변 분포만이 아니라 쌍 안의 차이의 분포입니다.
한쪽 측정값이 빠진 사람은 두 조건에서 같은 ID를 기준으로 처리해야 합니다. 두 열에서 각각 결측값을 제거한 뒤 순서대로 빼면 서로 다른 사람을 연결할 수 있습니다. 시간 경과나 순서 효과가 있다면 단순한 대응 검정만으로 연구 설계를 충분히 설명하지 못할 수도 있습니다.
검정 전에 어떤 조건을 확인할까요?
- 결과 변수가 평균으로 비교할 만한 수치형인가요?
- 관측값 또는 쌍들이 서로 독립인가요?
- 작은 표본에서 심한 왜도나 영향력이 큰 값이 있나요?
- 단측·양측 여부와 주된 비교를 결과를 보기 전에 정했나요?
정규성 검정은 표본이 작으면 검정력이 낮고, 표본이 크면 작은 일탈에도 반응합니다. 검정 결과 하나로 분석 방법을 자동 선택하기보다 그림, 설계, 표본 크기와 추정 목적을 함께 검토하세요.
Wilcoxon 검정을 단순히 “정규성이 없을 때 쓰는 평균 검정”이라고 설명하면 부정확합니다. 순위에 관한 다른 질문을 다루며, 위치 차이로 해석하려면 추가적인 분포 가정이 필요할 수 있습니다. 무작위화 검정이나 부트스트랩 역시 교환 가능성·표집 구조 등 적절한 조건이 필요합니다.
평균 차이와 불확실성은 어떻게 보고할까요?
독립 집단 예제에서는 집단별 n, 평균과 표준편차, 처리군−대조군의 평균 차이, 95% 신뢰구간, Welch 검정의 p-value를 적습니다. 대응 자료에서는 쌍의 수와 차이의 요약도 함께 보고합니다.
효과 크기와 신뢰구간에서 설명했듯 유의성만으로 실제 중요성을 판단할 수 없습니다. 여러 결과나 집단을 반복해서 비교했다면 주 분석과 탐색 분석을 구분하고 다중 비교도 고려해야 합니다.
무엇을 연결해서 기억하면 좋을까요?
검정 선택의 첫 질문은 두 열의 관계가 아니라 관측 단위의 관계입니다. 결과를 보고할 때는 신뢰구간과 효과 크기의 해석도 함께 연결해 보세요.
직접 해볼까요?
- 독립 집단 예제에서
t.test()의 두 인자 순서를 바꾸세요. 평균 차이·구간·p-value 중 무엇이 바뀌나요? t.test(difference, mu = 0)을 실행해 대응 검정과 비교하세요.- 같은 병원의 환자들이 섞여 있는 두 집단에서 독립성 가정이 왜 문제가 될 수 있는지 설명하세요.
댓글남기기