불균형 분류에서 ROC-AUC와 PR-AUC 함께 읽기
거짓 양성률이 1%라면 경보를 믿어도 될까요? 실제 양성이 드물면 음성의 1%도 많은 사람이 될 수 있겠죠. 점수의 순위와 경보의 신뢰도를 나누어 보는 이유입니다.
ROC와 정밀도·재현율(precision–recall) 곡선을 같은 자료에서 계산해 보겠습니다. 마지막에는 지표를 실제 임곗값과 비용의 질문으로 연결하겠습니다.
정확도가 높은데 왜 중요한 양성을 놓칠까요?
양성 비율을 π라고 두면 같은 재현율(TPR)과 거짓 양성률(FPR)에서도 정밀도가 달라질 수 있음을 식으로 볼 수 있습니다.
\[\mathrm{Precision}=\frac{\pi\,TPR}{\pi\,TPR+(1-\pi)FPR}.\]분모는 양성 경보 전체의 비율입니다. 분모가 양수인 상황에서 π가 작아지면 잘못된 경보가 차지하는 비중이 커질 수 있겠죠. 그래서 평가 자료의 양성 비율을 함께 보고해야 합니다.
모델 평가 글에서 모두 음성으로 예측해도 정확도가 높을 수 있다고 설명했습니다. 양성이 1%인 상황에서 거짓 양성률이 1%라면 작아 보이지만, 음성의 수가 매우 많으므로 잘못된 경보가 상당할 수 있습니다.
예를 들어 양성 100명·음성 9,900명에서 재현율 80%, 거짓 양성률 1%인 임곗값을 쓴다면 TP는 80명, FP는 99명입니다. 정밀도는 80 / (80 + 99), 약 44.7%입니다. 재현율과 거짓 양성률만 보고 양성 예측을 해석하면 이 차이를 놓칩니다.
작은 검증 자료로 계산을 따라가 볼까요?
별도 패키지 없이 실행할 수 있도록 점수와 정답 20개를 직접 만듭니다. 점수가 클수록 양성으로 판단하는 모형이며, 실제 양성은 3개입니다. 표본이 작고 인위적으로 만든 자료이므로 실제 모델의 성능 추정에 쓰는 예제는 아닙니다.
validation <- data.frame(
  actual = as.integer(1:20 %in% c(1, 3, 13)),
  score = c(0.95, 0.90, 0.85, 0.80, 0.75, 0.70, 0.65, 0.60,
            0.55, 0.50, 0.45, 0.40, 0.35, 0.30, 0.25, 0.20,
            0.15, 0.10, 0.05, 0.01)
)
mean(validation$actual)

metrics <- function(threshold) {
  predicted <- validation$score >= threshold
  positive <- validation$actual == 1
  tp <- sum(predicted & positive)
  fp <- sum(predicted & !positive)
  fn <- sum(!predicted & positive)
  tn <- sum(!predicted & !positive)
  c(TP = tp, FP = fp, FN = fn, TN = tn,
    recall = tp / (tp + fn),
    fpr = fp / (fp + tn),
    precision = if (tp + fp == 0) NA_real_ else tp / (tp + fp),
    cost = 100 * fn + 5 * fp)
}

thresholds <- c(Inf, sort(unique(validation$score), decreasing = TRUE))
curve <- data.frame(threshold = thresholds,
                    t(vapply(thresholds, metrics, numeric(8))))
curve
score >= threshold이면 양성으로 분류했습니다. 도구마다 양성 라벨이나 경계값 처리가 다를 수 있으므로 비교할 때 정의를 맞추세요.
ROC 곡선의 면적은 무엇을 뜻할까요?
roc_auc <- sum(diff(curve$fpr) *
                 (head(curve$recall, -1) + tail(curve$recall, -1)) / 2)

positive_scores <- validation$score[validation$actual == 1]
negative_scores <- validation$score[validation$actual == 0]
pairwise_auc <- mean(outer(positive_scores, negative_scores, ">") +
                     0.5 * outer(positive_scores, negative_scores, "=="))
stopifnot(isTRUE(all.equal(roc_auc, pairwise_auc)))
roc_auc
AUC는 약 0.784입니다. 무작위로 고른 양성이 음성보다 높은 점수를 받을 확률을 요약하며, 동점은 절반으로 처리합니다. 같은 점수를 가진 관측값은 함께 임곗값을 통과하게 만들었으므로 곡선 계산도 이에 맞습니다.
old_par <- par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
plot(curve$fpr, curve$recall, type = "l", lwd = 2, col = "#28765b",
     xlim = c(0, 1), ylim = c(0, 1),
     xlab = "False positive rate", ylab = "Recall", main = "ROC")
abline(0, 1, lty = 2, col = "gray50")

pr_precision <- curve$precision
pr_precision[1] <- 1
plot(curve$recall, pr_precision, type = "S", lwd = 2, col = "#b76a36",
     xlim = c(0, 1), ylim = c(0, 1),
     xlab = "Recall", ylab = "Precision", main = "Precision-Recall")
abline(h = mean(validation$actual), lty = 2, col = "gray50")
par(old_par)
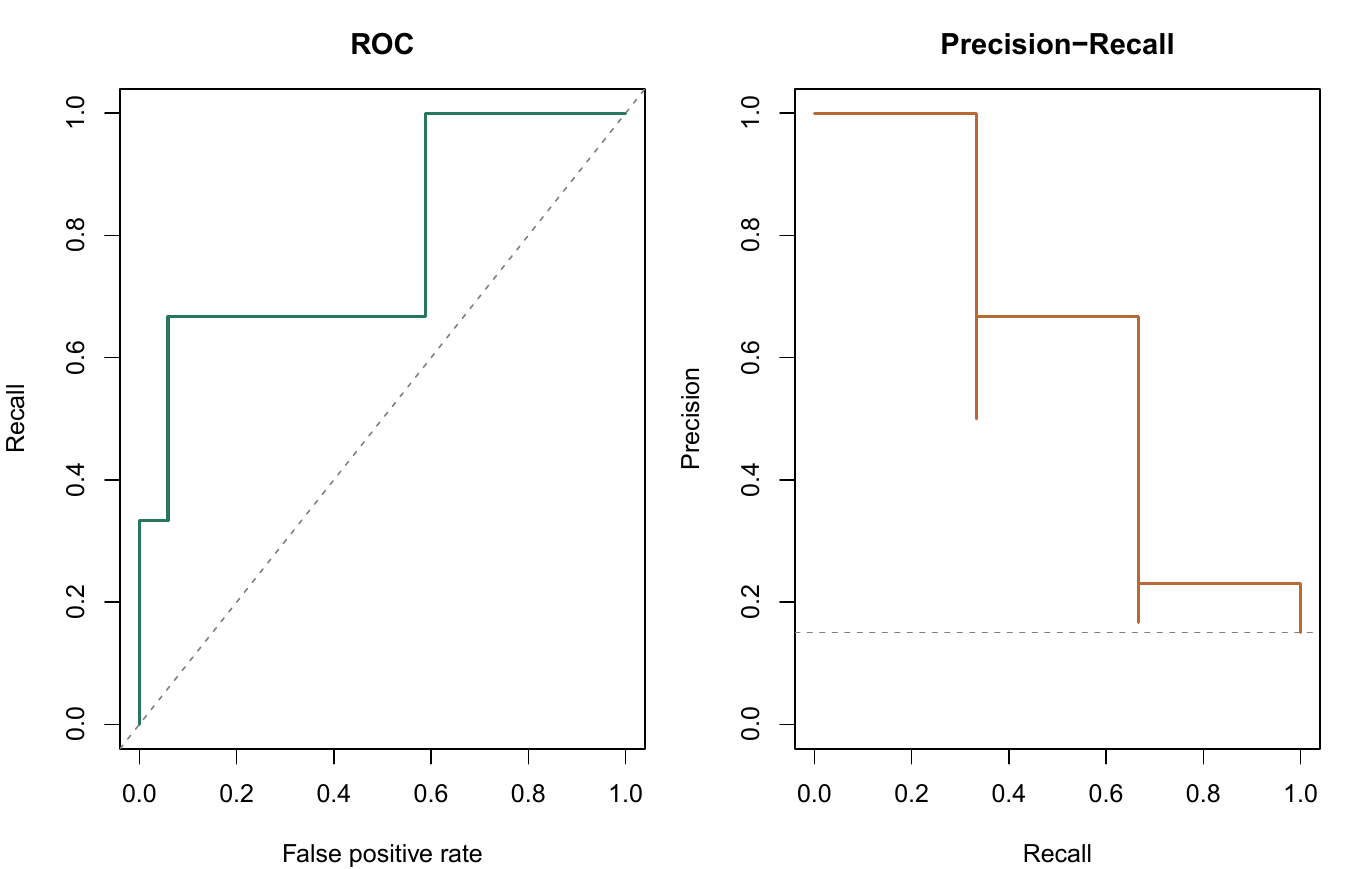
ROC-AUC가 양성 비율 변화에 완전히 둔감하다고 일반화하면 안 됩니다. 양성·음성 각각의 점수 분포가 같고 비율만 달라진다면 ROC는 유지될 수 있지만, 실제 환경에서 사례의 난이도나 분포도 달라지면 ROC 자체가 바뀔 수 있습니다.
PR 면적은 어떤 방식으로 계산했을까요?
PR 곡선에서는 양성 비율이 중요한 기준입니다. 모든 사례를 양성으로 선택하는 끝점의 정밀도는 이 자료에서 15%입니다. 무작위 순위의 모집단 PR 기준선도 양성 비율이며, 유한 표본의 평균 정밀도가 항상 그 값과 정확히 같지는 않습니다.
PR 면적은 보간·적분 방법에 따라 값이 달라질 수 있습니다. 여기서는 각 재현율 증가분에 그 지점의 정밀도를 곱해 더하는 Average Precision(AP, 평균 정밀도)를 계산합니다. 사다리꼴 PR-AUC와 같은 숫자라고 가정하지 마세요.
average_precision <- sum(diff(curve$recall) * curve$precision[-1])
average_precision
이 예제의 AP는 약 0.632입니다. 양성이 추가로 발견되는 순위 1, 3, 13에서 정밀도가 각각 1/1, 2/3, 3/13이므로 세 값의 평균과 같습니다. 첫 지점은 아무도 양성으로 예측하지 않아 정밀도가 정의되지 않습니다. 그림에서는 시작점의 관례로 1을 썼고, AP 계산에서는 제외했습니다.
다른 데이터셋의 AP를 비교할 때는 양성 비율과 평가 모집단을 함께 적으세요. AUC나 AP만으로 예측 점수가 잘 보정된 확률인지도 알 수 없습니다.
임곗값은 비용과 어떻게 연결할까요?
selected <- do.call(rbind, lapply(c(0.8, 0.5, 0.3), function(t) {
  data.frame(threshold = t, t(metrics(t)))
}))
selected

best <- curve[which.min(curve$cost), ]
best
양성 하나를 놓치는 비용을 100, 잘못된 경보 하나의 비용을 5로 가정했습니다. 예를 들어 임곗값 0.8에서는 TP=2, FP=2, FN=1, TN=15이고 비용은 110입니다. 0.5에서는 TP는 그대로인데 FP가 8로 늘어 비용은 140입니다.
이 가상 자료에서 비용이 가장 작은 후보는 0.35이고 총비용은 50입니다. 이는 작은 검증 자료와 특정 비용 가정에 따른 선택입니다. 이 임곗값이 현실에서 최적이라고 주장할 수는 없습니다. 실제 적용에서는 조사 가능 건수, 놓침의 피해, 확률 보정, 비용 추정의 불확실성도 고려하세요.
모델과 임곗값을 정한 뒤 별도로 보존한 테스트 자료에서 평가합니다. 위 예제에는 그 테스트 단계가 없으므로 선택한 후보의 최종 일반화 성능을 보고하는 데 사용할 수 없습니다.
무엇을 연결해서 기억하면 좋을까요?
AUC·AP는 순위를 요약하지만 실제로 어느 대상을 선택할지는 임곗값과 비용이 결정합니다. 평가 자료까지 준비하는 과정은 교차검증과 누수와 함께 되짚어 보세요.
직접 해볼까요?
- FN 비용을 100에서 10으로 바꾸면 선택되는 임곗값이 달라지나요?
- 음성 사례를 추가하되 기존 순위를 유지할 때 ROC와 정밀도에 어떤 변화가 생길지 계산해 보세요.
- 점수 0.9가 반드시 “양성일 확률 90%”를 뜻하지 않는 이유를 설명하세요.
댓글남기기