시계열 분석 7. 추세를 빼는 것과 차분은 어떻게 다를까요?
자료가 계속 증가하면 어떻게 분석할까요?
매출이 해마다 증가하고, 매출이 클수록 변동도 커지는 자료를 생각해 볼까요? 평균의 변화와 변동 폭의 변화는 서로 다른 문제입니다. 어떤 특징을 다룰지 나누어야 처리 방법도 정할 수 있겠죠.
변환(transformation)은 주로 척도와 분산 구조를, 추세 제거(detrending)는 정해진 시간 함수 주변의 변동을, 차분(differencing)은 이웃한 값의 차이를 다룹니다. 하나를 했다고 나머지 문제가 모두 해결되는 것은 아닙니다.
로그 변환은 언제 생각하나요?
수준이 높아질수록 변동의 절대 크기도 커진다면 로그 변환을 검토할 수 있습니다. 곱셈 관계가 덧셈 관계로 바뀌어 설명하기 편해지기 때문인데요. 0이나 음수에는 그대로 적용할 수 없습니다.
\[Z_t=\log X_t,\qquad Z_t-Z_{t-1}=\log\left(\frac{X_t}{X_{t-1}}\right).\]로그 차이는 변화가 작을 때 상대 변화율에 가까운 값입니다. 큰 변화에서도 정확한 백분율이라고 읽어서는 안 됩니다. 로그 차이가 $r$이면 정확한 상대 변화는 $e^r-1$입니다.
추세 제거와 차분은 무엇이 다를까요?
결정적 추세를 $X_t=\alpha+\beta t+U_t$로 설명한다면 회귀식으로 추세를 추정하고 $U_t$를 분석할 수 있습니다. 반면 랜덤워크처럼 충격이 수준에 누적되는 구조에는 차분이 더 자연스러울 수 있습니다.
\[\Delta X_t=X_t-X_{t-1}=(1-B)X_t.\]랜덤워크 $X_t=X_{t-1}+a_t$를 차분하면 $\Delta X_t=a_t$가 됩니다. 결정적 직선 추세를 뺀 것과는 다른 가정이죠. 차분 차수는 가능한 작게 두고 남은 구조를 확인하는 편이 좋습니다.
월별 자료의 계절 차분은 어떻게 하나요?
월별 항공 승객 자료 AirPassengers를 보겠습니다. 이후 평가를 위해 마지막 24개월을 남기고, 처음 120개월만 사용합니다. 단위는 월별 승객 수의 천 명 단위입니다.
data(AirPassengers)
training <- window(AirPassengers, end = c(1958, 12))
log_training <- log(training)
regular_difference <- diff(log_training)
seasonal_difference <- diff(log_training, lag = 12)
both <- diff(seasonal_difference)
old_par <- par(mfrow = c(3, 1))
plot(log_training, main = "Log passenger counts", ylab = "Log(count)")
plot(regular_difference, main = "First difference", ylab = "Difference")
plot(both, main = "Seasonal and first differences", ylab = "Difference")
par(old_par)
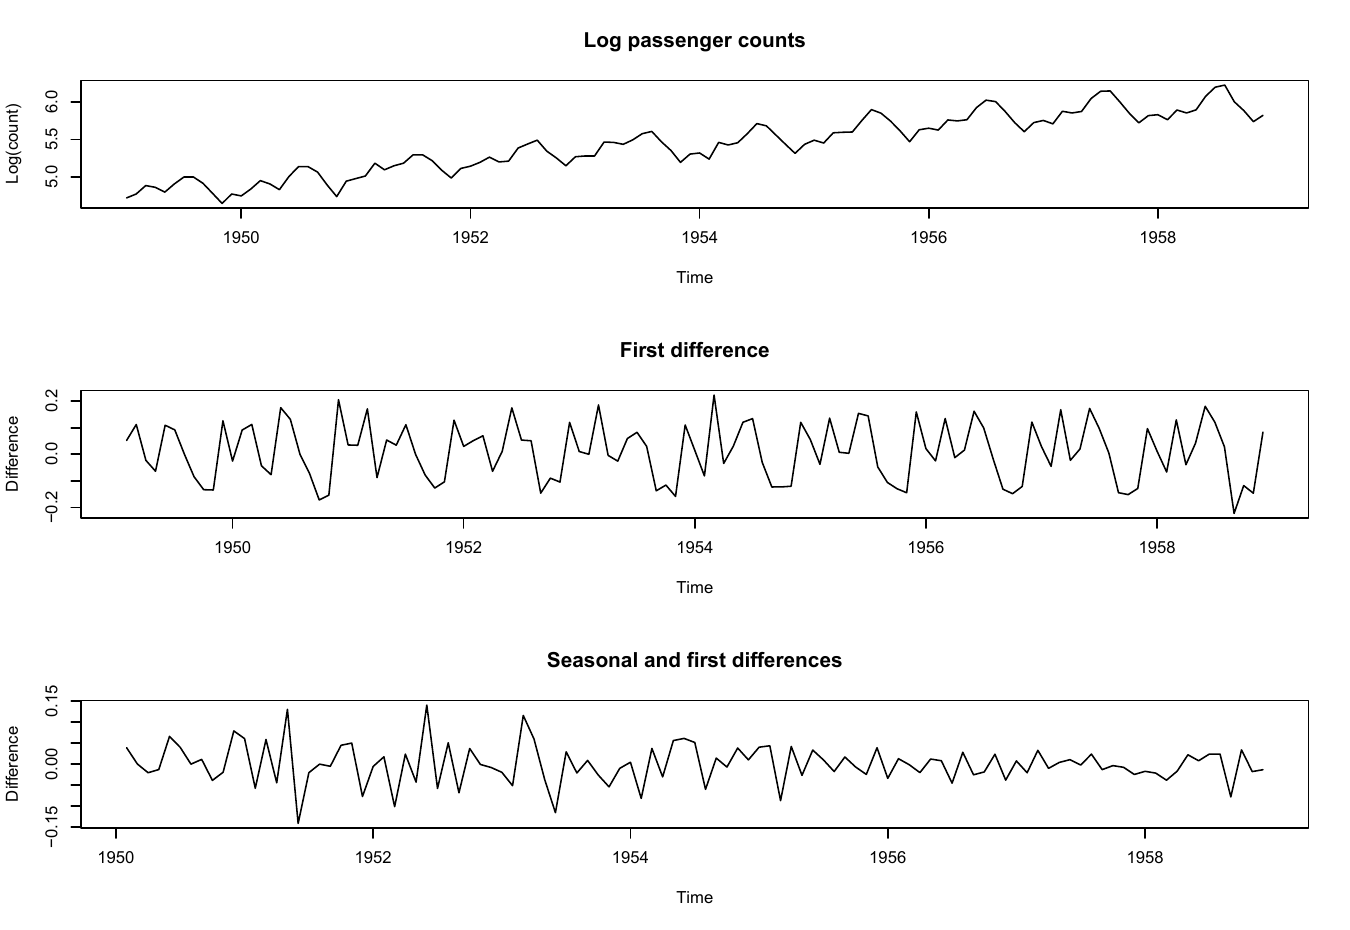
계절 차분은 같은 달의 전년 값과 비교하는 연산입니다.
\[\Delta_{12}X_t=X_t-X_{t-12}=(1-B^{12})X_t.\]이 예제에서는 두 차분을 함께 살펴봤지만, 모든 월별 자료에 둘 다 필요한 것은 아닙니다. 계절 더미나 다른 계절 모형으로 설명하는 선택도 있습니다.
차분은 많이 할수록 좋을까요?
이미 백색소음인 $a_t$를 차분해 보겠습니다. $a_t-a_{t-1}$는 MA(1) 구조이며 시차 1의 자기상관은 -1/2입니다. 필요하지 않은 음의 의존성을 새로 만든 셈이죠.
set.seed(107)
noise <- rnorm(1000)
c(before = as.numeric(acf(noise, plot = FALSE)$acf[2]),
  after = as.numeric(acf(diff(noise), plot = FALSE)$acf[2]))
c(before_variance = var(noise), after_variance = var(diff(noise)))
과차분(over-differencing)은 변동을 늘리고 추정·예측을 어렵게 할 수 있습니다. 표본 ACF의 강한 음의 첫 막대는 단서가 될 수 있지만, 이것만으로 확정하지는 않습니다.
단위근 검정으로 자동 결정하면 될까요?
ADF 검정은 단위근을 귀무가설로, KPSS 검정은 설정한 결정적 성분 주변의 정상성을 귀무가설로 사용합니다. 귀무가설이 서로 다르므로 p-value의 뜻도 다릅니다. 상수·추세·시차 설정에 따라 결과가 달라질 수 있고, 작은 표본에서는 정보가 부족할 수도 있습니다.
검정 하나가 “정상성이 증명되었다”는 인증서는 아닙니다. 수집 과정, 그래프, 모형의 가정, 검증 결과를 함께 봐야 합니다. 변환의 기준이나 추세 계수 역시 학습 자료에서 정하고 미래 구간에 적용하세요.
다음에는 무엇을 배우면 좋을까요?
차분 뒤 남은 부분을 ARMA로 설명하면 원래 수준을 위한 모형도 만들 수 있습니다. 다음 글에서 이 구조를 ARIMA라는 이름으로 연결해 보겠습니다.
직접 생각해 보기와 참고 자료
- 일반 차분을 두 번 적용하면 원래의 몇 개 관측값이 직접 사용 가능한 시작 부분에서 사라질까요?
- 계절 차분과 일반 차분을 모두 쓰면 어떤 과거 시점들이 식에 들어가는지 전개해 보세요.
댓글남기기