시계열 분석 8. ARIMA의 세 숫자는 무엇을 뜻할까요?
차분한 값을 예측하면 원래 값도 예측할 수 있을까요?
앞 글에서는 차분으로 수준의 누적 변화를 다뤘습니다. 차분한 값의 미래를 예측한 뒤 다시 누적하면 원래 수준으로 돌아올 수 있겠죠. 이 생각을 모형으로 정리한 것이 ARIMA(autoregressive integrated moving average)입니다.
integrated는 차분의 반대 방향으로 누적해 원래 수준을 복원한다는 의미로 이해하면 좋겠습니다. 미래의 실제값을 끼워 넣는다는 뜻은 아닙니다.
p, d, q는 각각 무엇인가요?
| 기호 | 의미 | 먼저 확인할 질문 |
|---|---|---|
| p | 차분 후의 AR 차수 | 과거 값의 영향은 얼마나 남나요? |
| d | 일반 차분 횟수 | 수준 변화를 몇 번 차분하나요? |
| q | 차분 후의 MA 차수 | 과거 오차의 영향은 얼마나 남나요? |
시차 연산자를 사용하면 다음처럼 정리할 수 있습니다.
\[\phi(B)(1-B)^dX_t=\theta(B)a_t.\]이 식은 상수나 추세 항을 생략한 기본 형태입니다. d가 0이면 ARMA로 돌아갑니다. d가 1인 모형에 상수항을 넣으면 원래 수준에서 선형적인 drift가 생길 수 있어, 상수의 의미도 차분 전후에 구분해야 합니다.
연간 자료로 모형을 적합해 볼까요?
Nile은 1871~1970년 나일강 연간 유량 자료 100개입니다. 유량의 단위는 10⁸m³입니다. 처음 80개만 개발에 사용하고, 마지막 20개는 이후에 평가할 자료로 남겨 두겠습니다. 이 자료에는 수준 변화가 있을 수 있으므로 ARIMA를 적용했다고 구조 변화 문제가 자동으로 해결되는 것은 아닙니다.
data(Nile)
training <- window(Nile, end = 1950)
testing <- window(Nile, start = 1951)
orders <- list(MA_diff = c(0, 1, 1), AR_diff = c(1, 1, 0),
               ARMA_diff = c(1, 1, 1))
fits <- lapply(orders, function(order) {
  arima(training, order = order, method = "ML")
})
scores <- sapply(fits, AIC)
scores
selected_name <- names(which.min(scores))
fit <- fits[[selected_name]]
selected_name
여기서는 d=1로 고정한 작은 후보 집합을 비교했습니다. 차분 횟수를 AIC만으로 무제한 탐색하지 않습니다. 실제 분석에서는 개발 자료 안의 시간순 검증과 잔차 진단을 더해 선택하는 것이 좋겠죠.
R의 arima()는 차분이 있는 모형에서 include.mean을 무시합니다. 자동으로 drift까지 추정한다고 생각하면 안 됩니다. drift를 포함하려면 시간 회귀항 등 모형의 식과 예측 시점의 입력을 명시해야 합니다.
미래 오차는 어떻게 처리하나요?
forecast <- predict(fit, n.ahead = length(testing))
point <- as.numeric(forecast$pred)
se <- as.numeric(forecast$se)
lower <- point - qnorm(0.975) * se
upper <- point + qnorm(0.975) * se

plot(Nile, ylab = "Annual flow", main = "ARIMA forecast from 1950",
     ylim = range(c(Nile, lower, upper)))
polygon(c(time(testing), rev(time(testing))), c(lower, rev(upper)),
        col = adjustcolor("#8db8a3", alpha.f = 0.4), border = NA)
lines(testing, col = "#333333")
lines(as.numeric(time(testing)), point, col = "#b56535", lwd = 2)
abline(v = 1950, lty = 2)
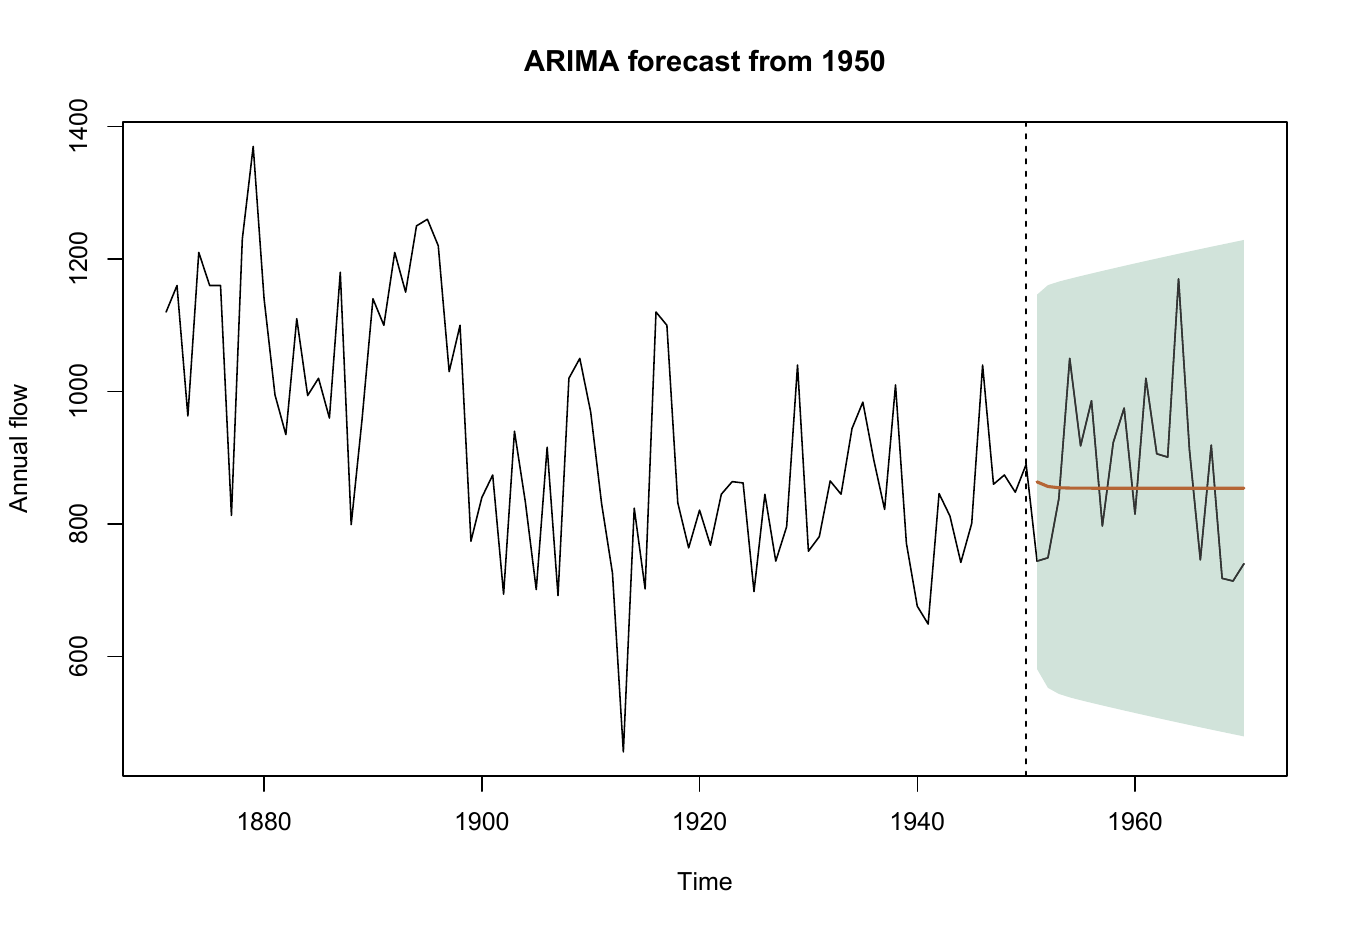
여러 시점 앞을 예측할 때는 아직 관측하지 못한 미래 값을 재귀적으로 예측합니다. 미래 혁신의 평균은 0으로 두고, 혁신 때문에 생길 수 있는 변동은 예측 표준오차에 반영합니다. 실제 미래 관측값을 중간에 넣었다면 같은 고정 원점 예측이 아닙니다.
여기서 구간은 적합한 정규 모형을 기준으로 한 점별 약 95% 예측구간입니다. 전체 미래 경로가 동시에 들어갈 확률이 95%라는 뜻은 아니며, 보통 모수 추정의 불확실성은 충분히 반영하지 않습니다.
마지막에는 무엇과 비교해야 할까요?
baseline <- rep(tail(as.numeric(training), 1), length(testing))
rmse <- function(prediction) sqrt(mean((as.numeric(testing) - prediction)^2))
data.frame(model = c("Last observed value", selected_name),
           RMSE = c(rmse(baseline), rmse(point)))
마지막 관측값을 계속 사용하는 naïve 예측은 중요한 기준입니다. 복잡한 모형이라도 기준보다 개선되는지 확인해야 하죠. 이 테스트 결과를 본 뒤 같은 구간에 맞춰 모형을 반복 수정하면 독립적인 최종 평가가 아니게 됩니다.
이 예제에서는 AIC로 고른 ARIMA(1,1,1)의 테스트 RMSE가 약 125.05이고, 마지막 값 기준은 약 123.06입니다. 복잡한 후보가 오히려 조금 나쁩니다. 학습 적합도를 바탕으로 고른 모형이 미래의 기준 예측을 반드시 이기지는 않는다는 점을 보여주죠. 결과를 좋게 만들려고 테스트 구간에 맞춰 차수를 다시 고르지는 않겠습니다.
다음에는 무엇을 배우면 좋을까요?
ARIMA의 세 숫자는 차분한 자료의 구조를 간단히 나타냅니다. 그런데 매년 같은 달에 반복되는 변화는 어떻게 표현할까요? 다음 글에서 계절성과 시계열 분해를 살펴보겠습니다.
직접 생각해 보기와 참고 자료
- ARIMA(0,1,0)에 drift가 없으면 점 예측이 왜 마지막 관측값과 같을까요?
- 수준의 구조 변화가 의심된다면 차분 횟수를 늘리기 전에 무엇을 확인해야 할까요?
댓글남기기